SONiCとTelemetry, AIで作るクローズドループ基盤(1) ~全体概要編~
本連載では、SONiCとTelemetry, AIを用いたクローズドループ基盤を構築します。初回となる今回は全体概要を紹介します。


テクノロジーコラム
- 2026年09月17日公開
はじめに
こんにちは、NTTテクノクロスの山口です。
これまでのブログ記事でSONiCやTelemetry、監視基盤、AIなどについて紹介してきました。
今回は、本記事を含めた5記事にわたって、それらを活用したクローズドループを実現できる監視/制御基盤の例を紹介したいと思います。
環境の作り方や動作もご紹介しますので、各技術のイメージやネットワーク世界でのAI活用、クローズドループについて、そしてネットワーク管理の将来像についてイメージを膨らませられれば、と思います。
初回となる本記事では、本連載で作る環境や検証シナリオなどの全体の概要について紹介します。
※ 次回から環境構築や動作説明に入りたいと思います。
【目次】
| 記事 | 章 | 節 | 項 |
|---|---|---|---|
| 第1回 (今回) |
クローズドループとは | - | - |
| 本連載で作る環境と検証シナリオ | - | - | |
| 構築環境と手順に関する前提 | - | - | |
| 完成した環境での検証結果概要 | - | - | |
| 第2回 | 環境の作り方 (各サーバ設定) |
1. 全体像 | - |
| 2. SONiC | - | ||
| 3. 試験トラヒック用サーバ | - | ||
| 4. 監視/制御サーバ | - | ||
| 第3回 | 環境の作り方 (監視/可視化基盤) |
1. 全体像と全体設定 | - |
| 2. Telegraf | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 3. Prometheus | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 4. Grafana | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 【補足】 5. Prometheusによる ルールベース異常判定の準備 |
A. 設計・方針整理 | ||
| B-1. 構築手順(ルール定義) | |||
| B-2. 構築手順(Prometheus) | |||
| B-3. 構築手順(Alertmanager) | |||
| C. 起動と動作確認 | |||
| D. その他 | |||
| 第4回 | 環境の作り方 (AIによる判断と制御基盤) |
1. 全体像 | - |
| 2. AI利用に関する設計と事前準備 | ① AIに関する設計 | ||
| ② データの収集 | |||
| ③ AIの学習用データの選定/抽出 | |||
| 3. 学習ツール | ④ データの加工(前処理)~ ⑥ 精度確認(モデルの評価) |
||
| 4. 推論ツール | ⑦ AIモデルの利用(推論) | ||
| 5. 経路切り替えツール | - | ||
| 6. 定期実行の実現 | - | ||
| 第5回 | 環境の作り方 (LLMによる問い合わせ支援基盤) |
1. 全体像 | - |
| 2. チャット機能 | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 検証シナリオの実施と結果 | 1. AIを用いたクローズドループ環境検証 | Ⅰ. 手順概要 | |
| Ⅱ. 手順実施と結果 | |||
| 【補足】 2. ルールベース異常判定の検証 |
Ⅰ. 手順概要 | ||
| Ⅱ. 手順実施と結果 |
[参考] 関連記事
良ければこちらも参照ください。
| 関連内容 | 記事 |
|---|---|
| SONiC | NOS入門第1回, NOS入門第2回 |
| Telemetry | 監視入門第1回 |
| 監視基盤 | 監視入門第2回 |
| AI(LLM) | LLM活用入門第1回 など |
クローズドループとは
ネットワーク(NW)の世界ではいかに早くに異常を察知し、手立てが行えるかが極めて重要です。
そこで【監視入門 第2回】記事でも紹介したようにNW機器から様々な情報を取得し、異常の発見や判断に活用します。
また、必要に応じて対処も行います。
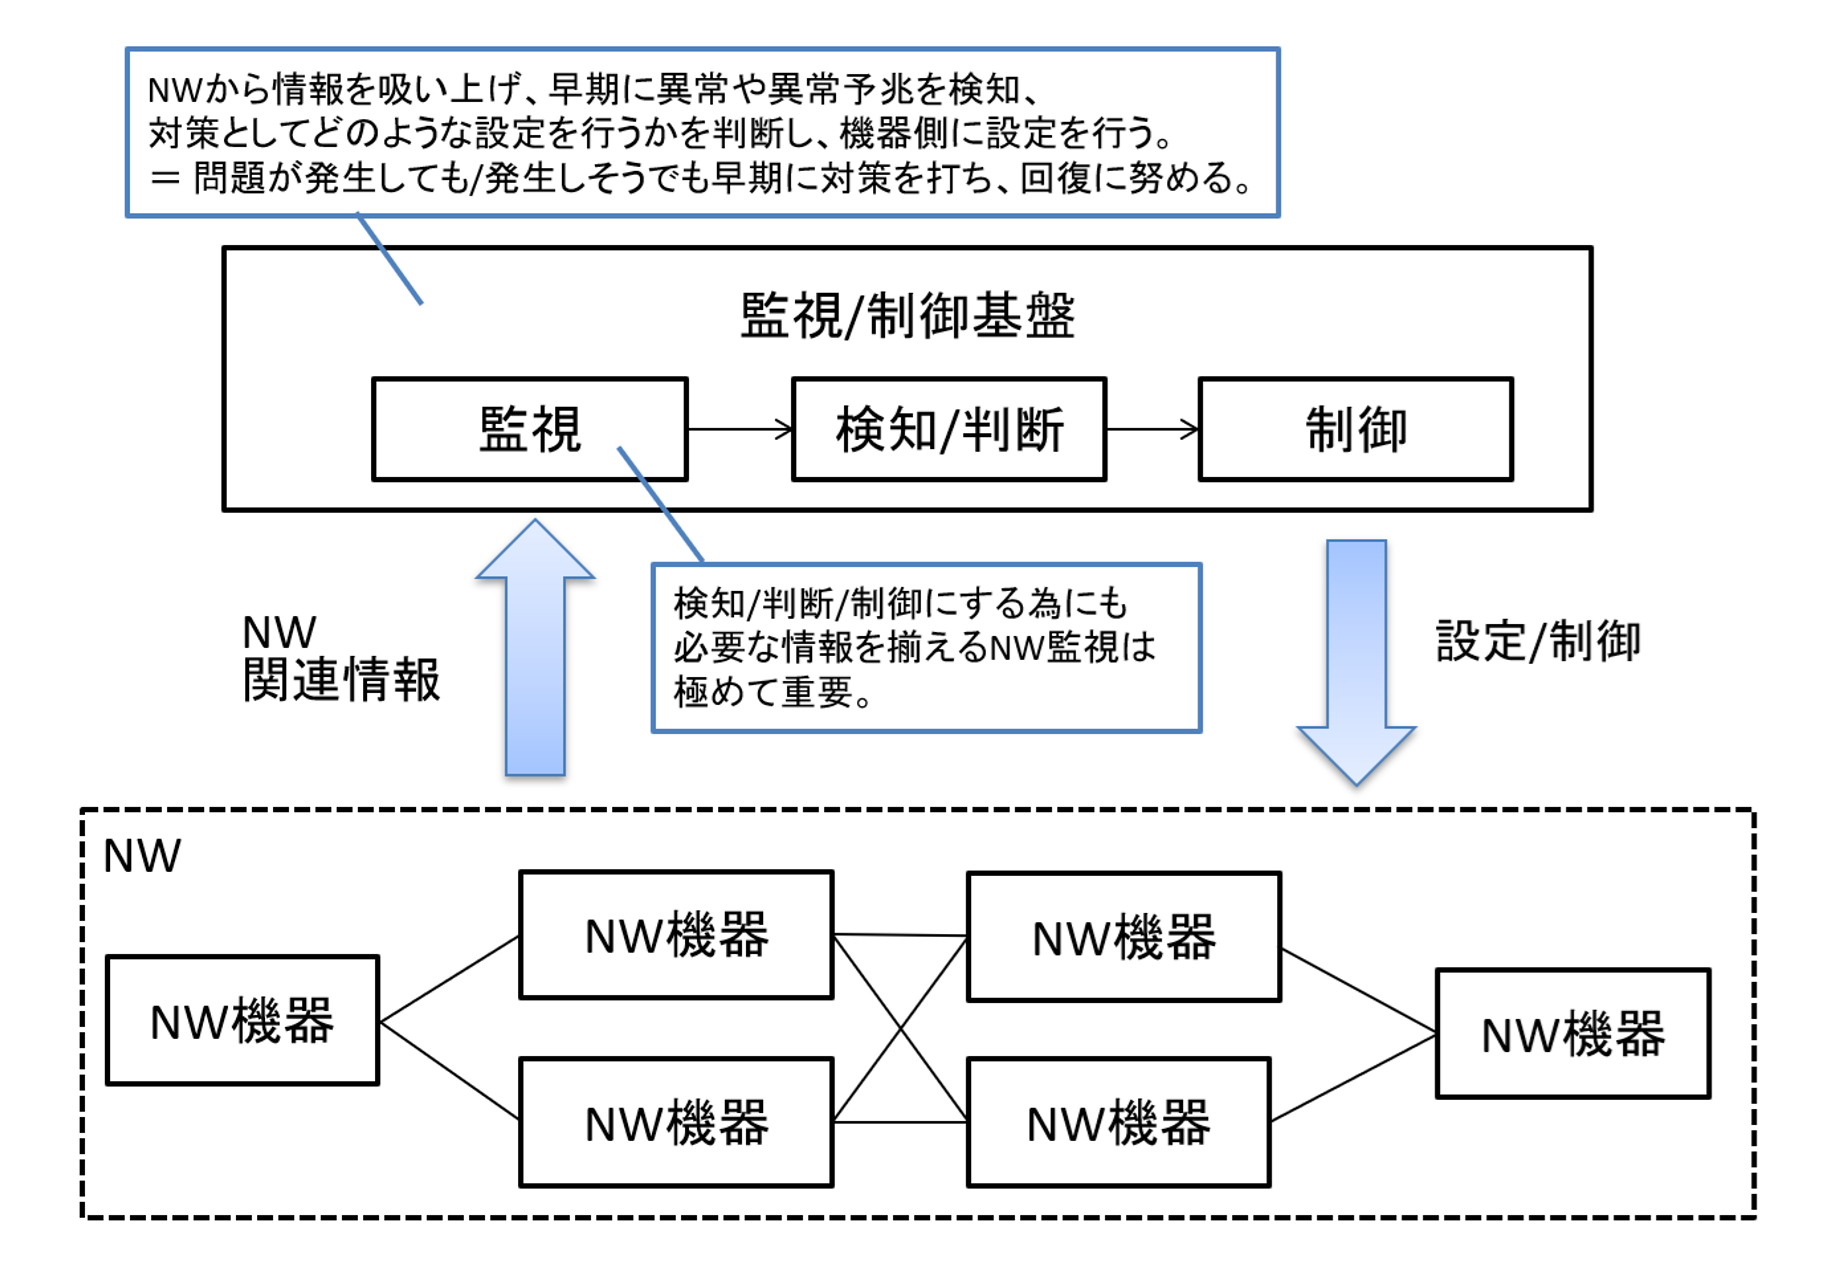
図1 NW管理の全体像
これらを自動的/自律的に行い、継続的に循環させる仕組みをもったNWを自律型ネットワークといったりクローズドループ自動化ネットワーク、あるいはインテリジェントネットワークと呼んだりします。
今回はOSSや簡単なプログラムで簡易的な検証環境を作り、イメージを膨らませていければ、と思っています。
本連載で作る環境と検証シナリオ
クローズドループの概念をおさえられたところで、次回から4回にわたり作っていく検証環境の構成概要を以下の図に示します。
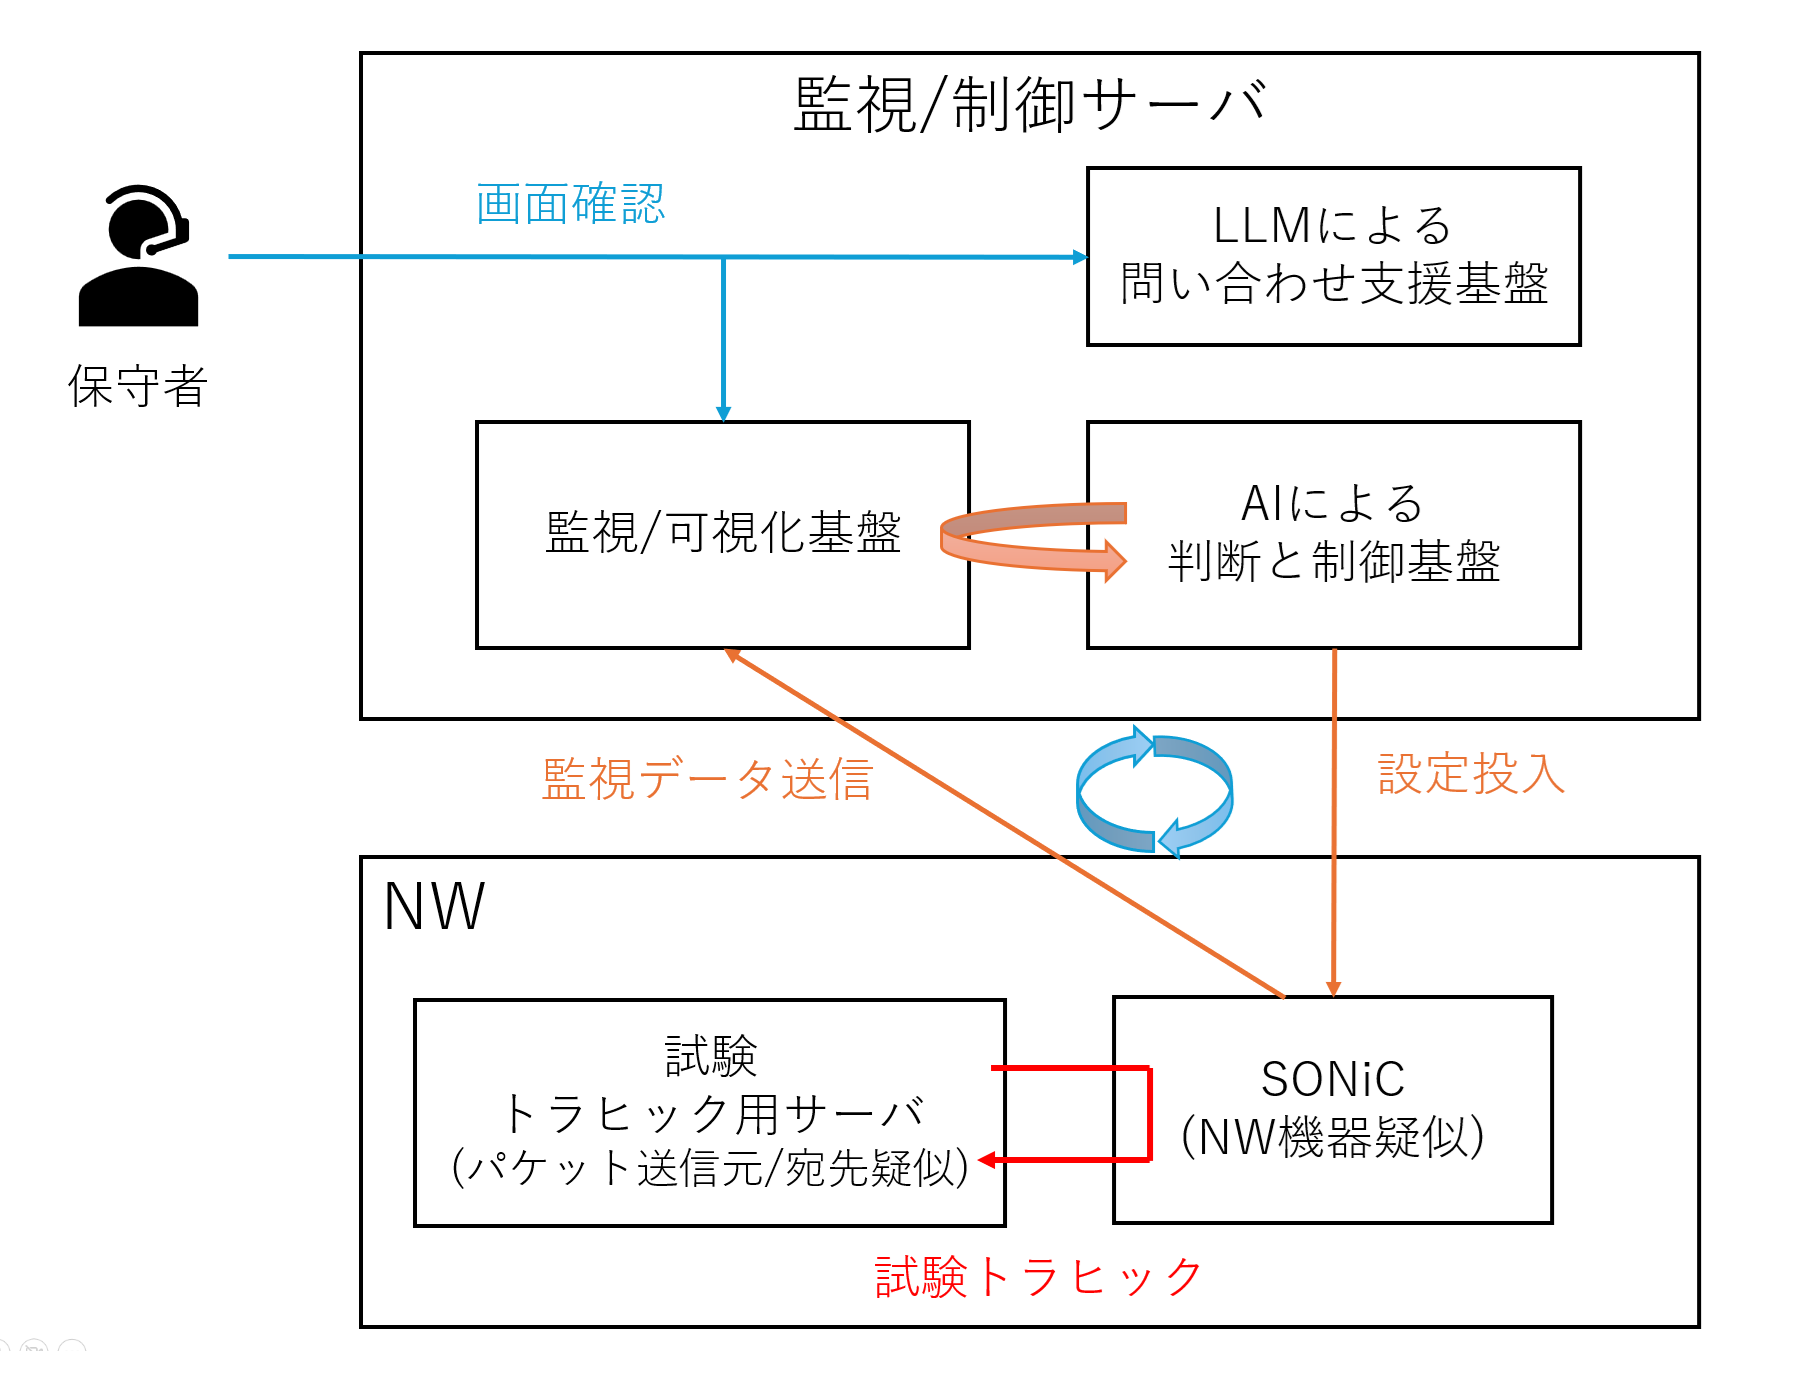
図2 本連載で扱う構成の概要
クローズドループの基本要素は「監視」「判断」「制御」ですが、実運用では発生した異常の内容を保守者が理解し、対応内容を確認できることも重要です。
そのため今回は、異常発生時の状況確認や原因整理を支援する要素として、「LLMによる問い合わせ支援」も構成に加えています。
NW領域におけるLLMの活用例の一例としても紹介できれば、と思います。
これらにより実現することは「NWの状態可視化」「NW監視と制御の連携と自動化による対処早期化」「NW異常時の状態把握の早期化」です。
今回はこれを実現するシンプルなシナリオとして、NW機器のトラヒック流量を監視し、普段より多くの通信が来たらAIにて異常と判定、その後経路を自動的に切り替える、ということを行いたいと思います。
監視/可視化基盤でNW機器から情報を取得、かつトラヒック流量を見える化することで「NWの状態を可視化」し、AIによる判断と制御基盤による処理で「NW監視と制御の連携と自動化による対処早期化」を実現、またLLM問い合わせ支援基盤で「異常と判定された理由」をLLMに問い合わせることで「NW異常時の状態把握の早期化」の実現を確認するイメージです。
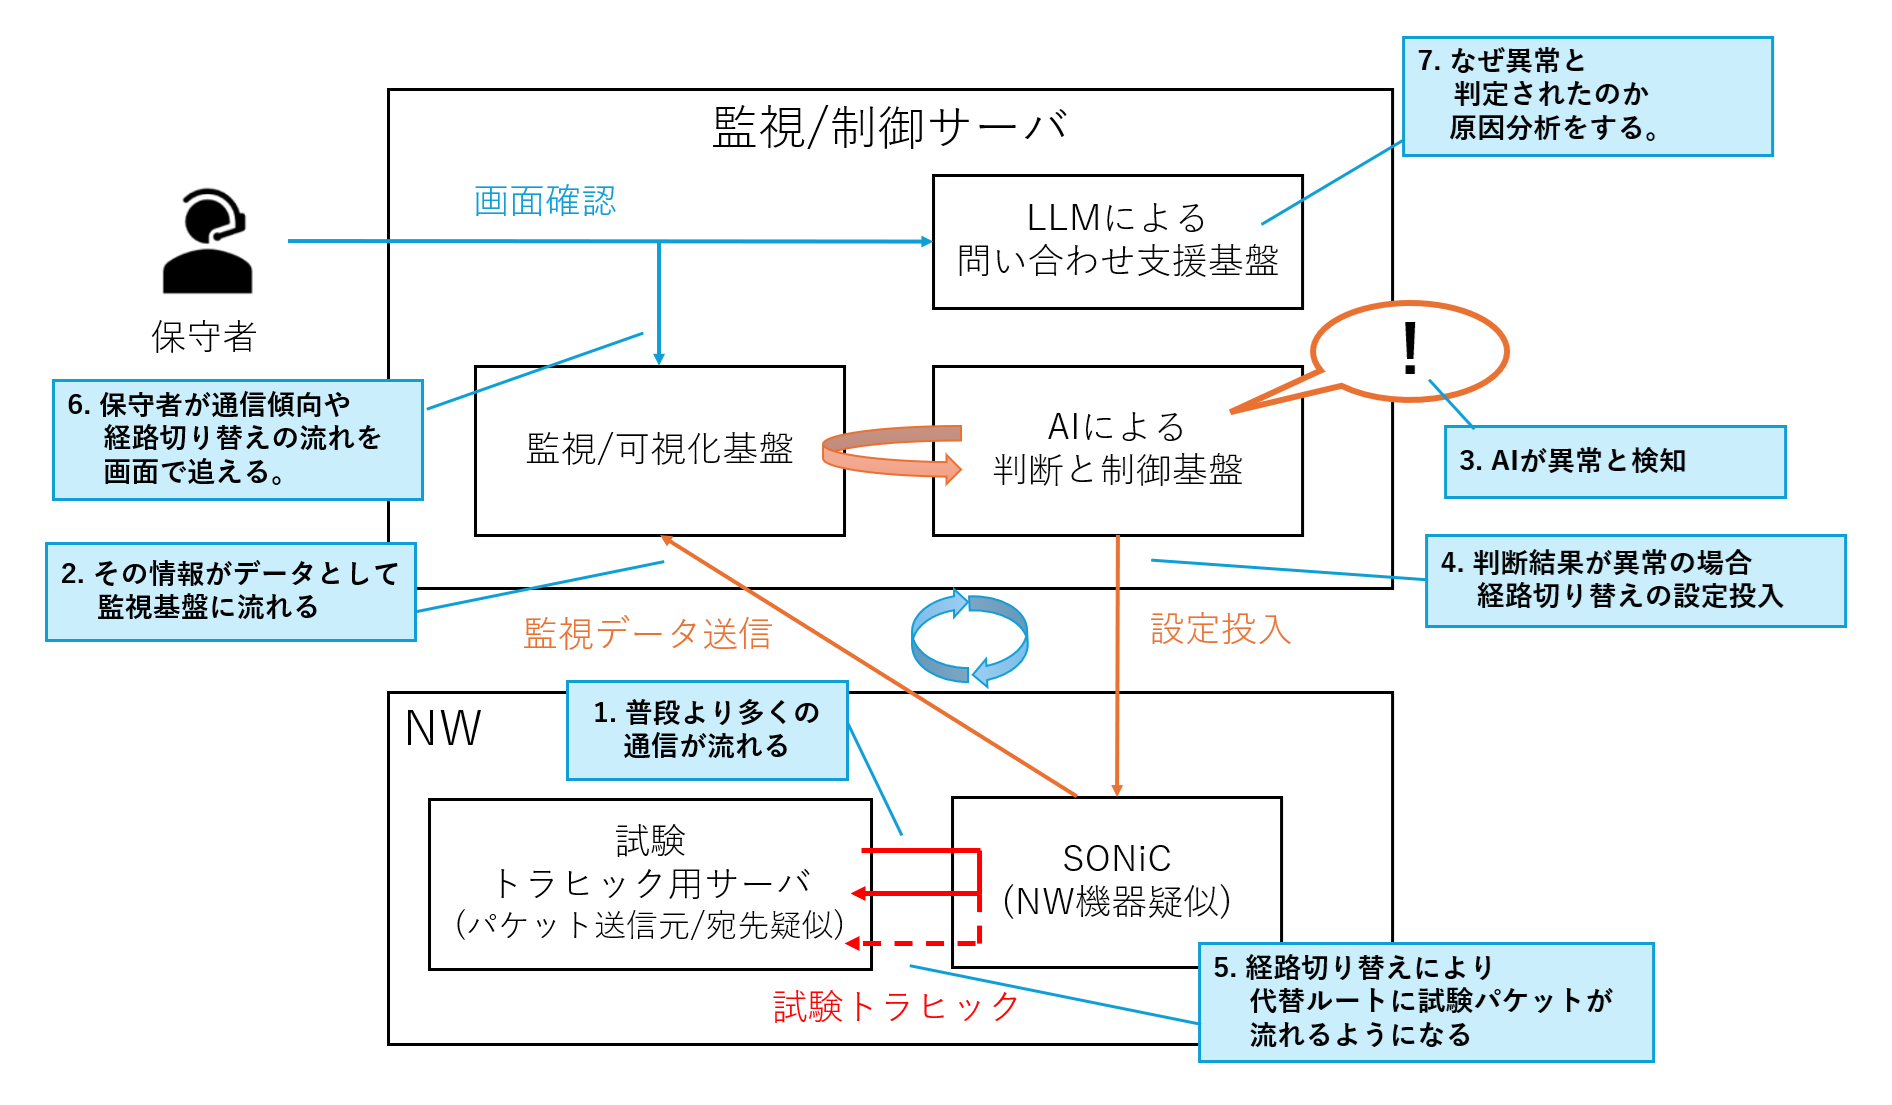
図3 検証シナリオのイメージ
大量の通信が来た場合に経路を切り替えても、大量通信は減らないのだから本質的に解決しないのでは(異常の内容と対処案が紐づいていないのでは)と思われるかもしれません。
これはご認識の通りで、実際には振り分け(ロードバランス)経路の追加やQoS対応などが該当するかと思いますが、今回はシンプルな例とする為、経路切り替えの例で実施したいと思います。
気になる方は対処内容のところは頭の中で読み替えて見ていただけるとよいかと思います。
このシナリオを実現するために検証環境を作っていきます。
図2の内容をもう少し利用する具体的な技術名も含めて記載すると以下のようになります。
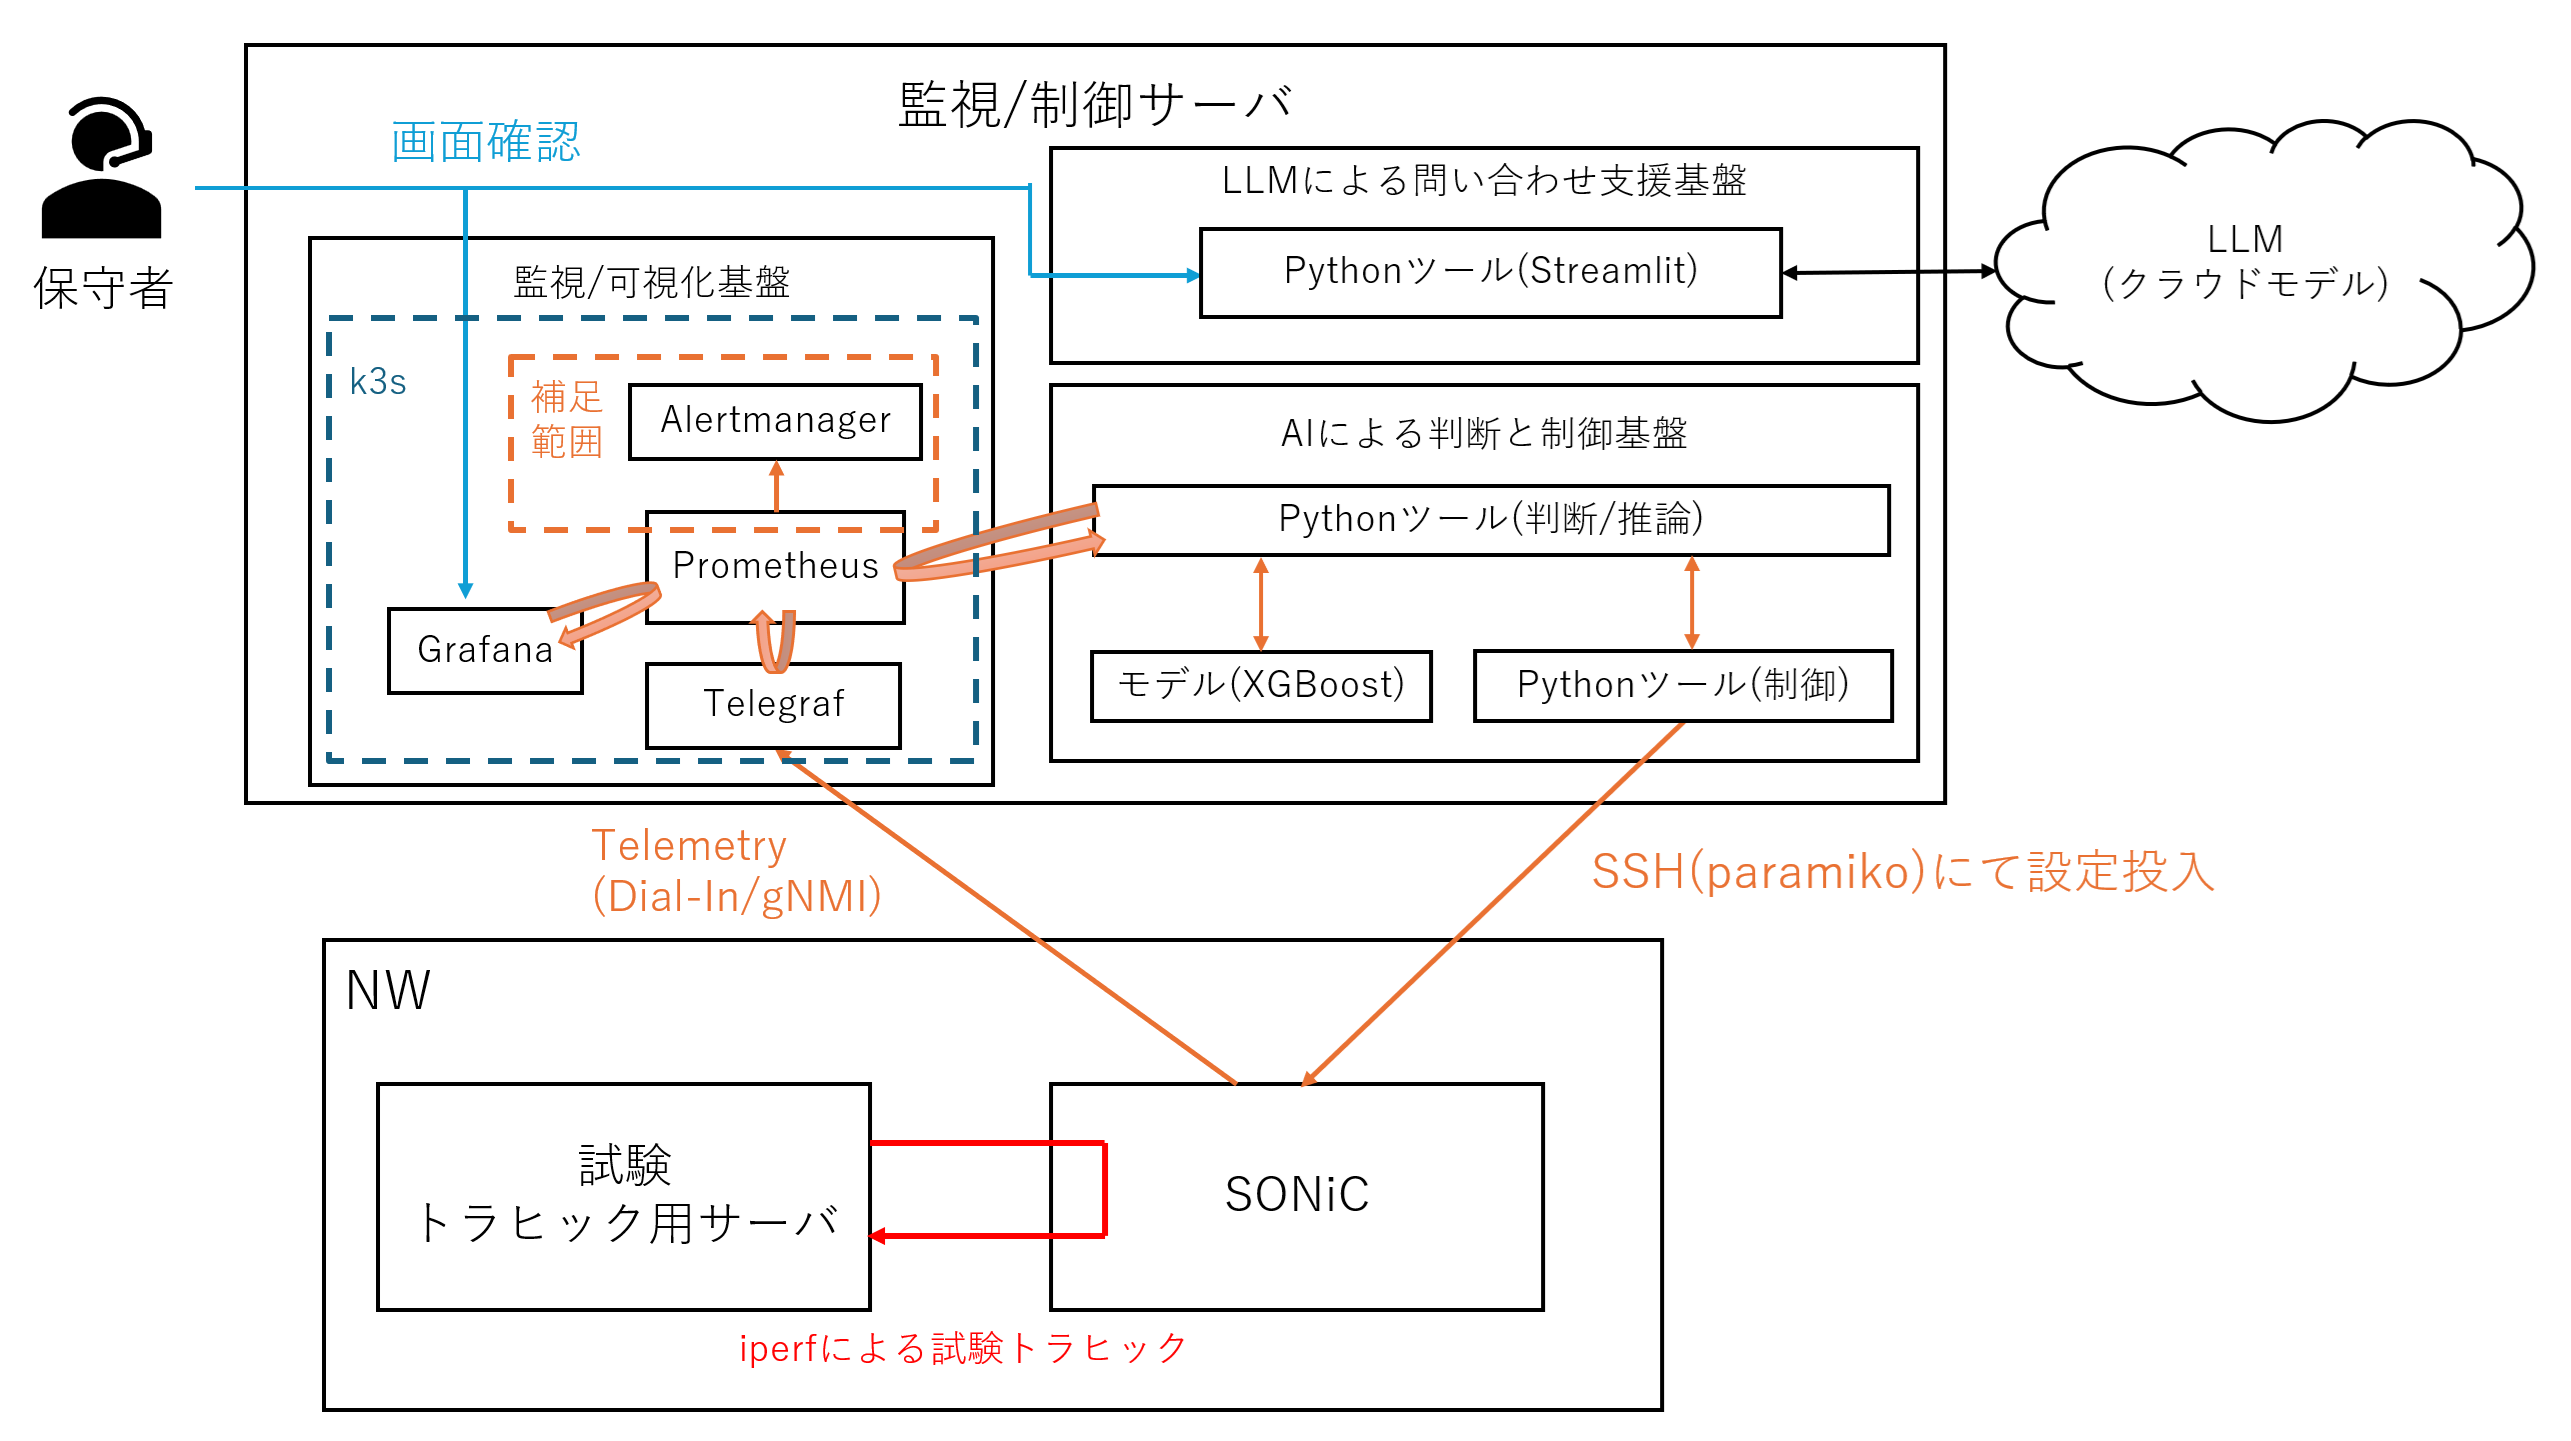
図4 本シリーズが扱う検証環境の構成詳細
NW機器の部分はSONiCが担います。
SONiCはホワイトボックス機器向けのNetwork Operating System(NOS)です。
[参考] 詳細は【NOS入門 第1回】をご確認ください。
SONiCからのデータ収集はTelemetryを活用したいと思います。
TelemetryはNW機器からデータ収集するための方法の1つです。
[参考] 詳細は【監視入門 第1回】、【同 第2回】をご確認ください。
Telemetryの取得方式には大きくDial-InとDial-Outがありますが、今回はDial-In方式で実現します。
また、Telemetryの収集コレクタはTelegrafを利用します。
[参考] Dial-In/Dial-OutやTelegrafについては【監視入門第1回】もご確認ください。
前述の通り、TelegrafはTelemetry収集をするためのコレクタの役割を担います。
TelegrafでSONiCからIFのトラヒック流量を取得し、Prometheus・Grafanaへとあげていきます。
データ管理についてはPrometheus、可視化についてはGrafanaが担います。
データ欠損を極力しないような構成を目指したり複数のデータ管理先にデータを送るのであればBrokerとしてKafkaを入れる、あるいはSyslogやルーティング情報といった文字列を管理するならOpenSearchを利用するのも手かと思いますが、今回はシンプルな構成、かつ管理する情報がトラヒック情報(数値情報)となるのでPrometheusと、Prometheusとかみ合わせの良いGrafanaを利用します。(この点が【監視入門第1回】で挙げた構築例との差分でもあります)
異常判断については、Pythonツールで定期的にPrometheusから直近のデータを受け取りながら、AI、今回はXGBoostの回帰処理という方式を利用して判断します。
XGBoostで検知する「異常」の定義は、傾向外れです。
すなわちXGBoostにて通常時のトラヒック流量の傾向を学習し、傾向から外れた場合に異常と判定します。
傾向外れを異常として検知する理由は、安定運用している状態(通常時)から外れた場合、逆説的に考えると異常につながる可能性や異常が発生している可能性があるためです。
異常と判断された場合はPythonツールにてSONiCの経路を切り替えます。
今回のシナリオでは前述の通り、「普段より多くトラヒックを流す」ケースで試しますが、傾向外れは「普段より減少した場合」も検知できます。
本記事の主題は監視とAIによる判断、制御の連動(クローズドループ化)である為、本題とは少しそれますが、補足としてPrometheusによるルールベース異常の検知とAlertmanagerによる通知も紹介します。
LLMを用いた問い合わせ支援基盤は、保守者が利用しやすいようにチャット画面を用意します。
このGUIの作成にStreamlitを活用し、実際に問い合わせを行うLLMはOpenAI社のモデル(クラウドモデル)を利用します。
【LLM活用入門 第1回】、【同 第2回】で紹介したようにDifyやローカルLLMを使うという手もありますが、今回はシンプルなものとする為、前述のような構成とします。
その他、細かい動作や補足などは、次回以降の「環境の作り方」章で紹介していきたいと思いますので、操作や動きも見ながら細部のイメージを掴んでいただければ、と思います。
なお、今回は検証デモ用でかつ環境準備の簡略化の為、各コンポーネントは説明用に最低限の設定や実装となっておりますこと、ご承知おきください。
また、本記事の内容を用いた開発・運用は、必ずご自身の責任と判断によって行ってください。
開発・運用の結果について、いかなる責任も負いません。
| [補足] 監視/制御の関係とIntent-Based Networking 今回の記事では監視されたNWに対し、自動で異常を検知し必要な対処/制御を行う、という内容である為、まずは「監視」が先に来る(監視があって制御が成り立つ)ように見えるかもしれません。 一方でNWを継続的に安定運用させる上では監視と制御をシステム的に組み合わせることが重要です。 この考え方は、近年注目されているIntent-Based Networking(IBN)にも通じます。 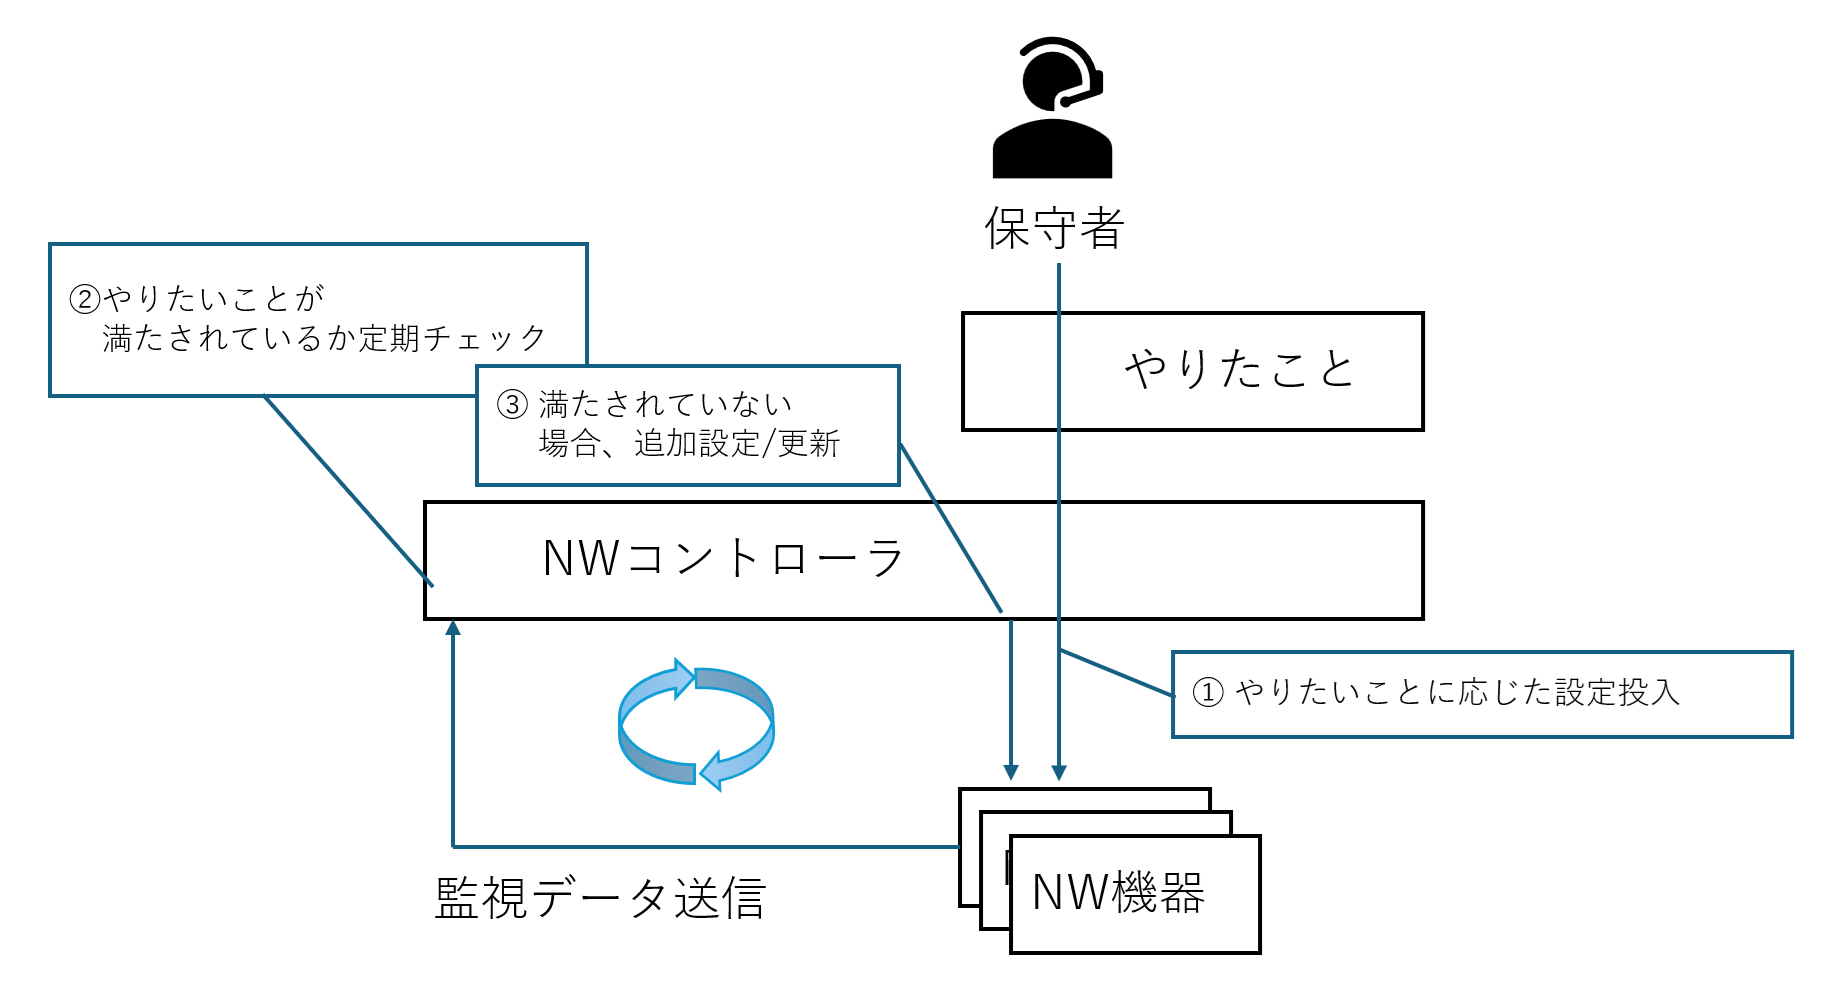
図5 Intent-Based Networkingのイメージ 最初はIntentに基づいて必要な設定をNW機器へ投入することになるかと思いますが、Intentを満たし続けるためには、やはり設定投入だけでは不十分です。 今回の検証はIBNそのものを実装するものではありませんが、監視、判断、制御を組み合わせてNWを自動で望ましい状態へ近づけるという点で、IBNに通じる考え方も含んでいます。 |
|---|
| [補足] ルールベース検知とAIによる異常検知の違い ルールベースによる異常の検知とAIによる異常検知の違いについて補足します。 ルールベースの検知は、基本的に人が事前に定義した条件によって判断されるものです。 ところがこのようなパターンでは、実運用での傾向などを細かく反映しづらい点があります。 AIを活用すると、実際に発生したものの傾向から機械が正常/異常判断をしてくれます。 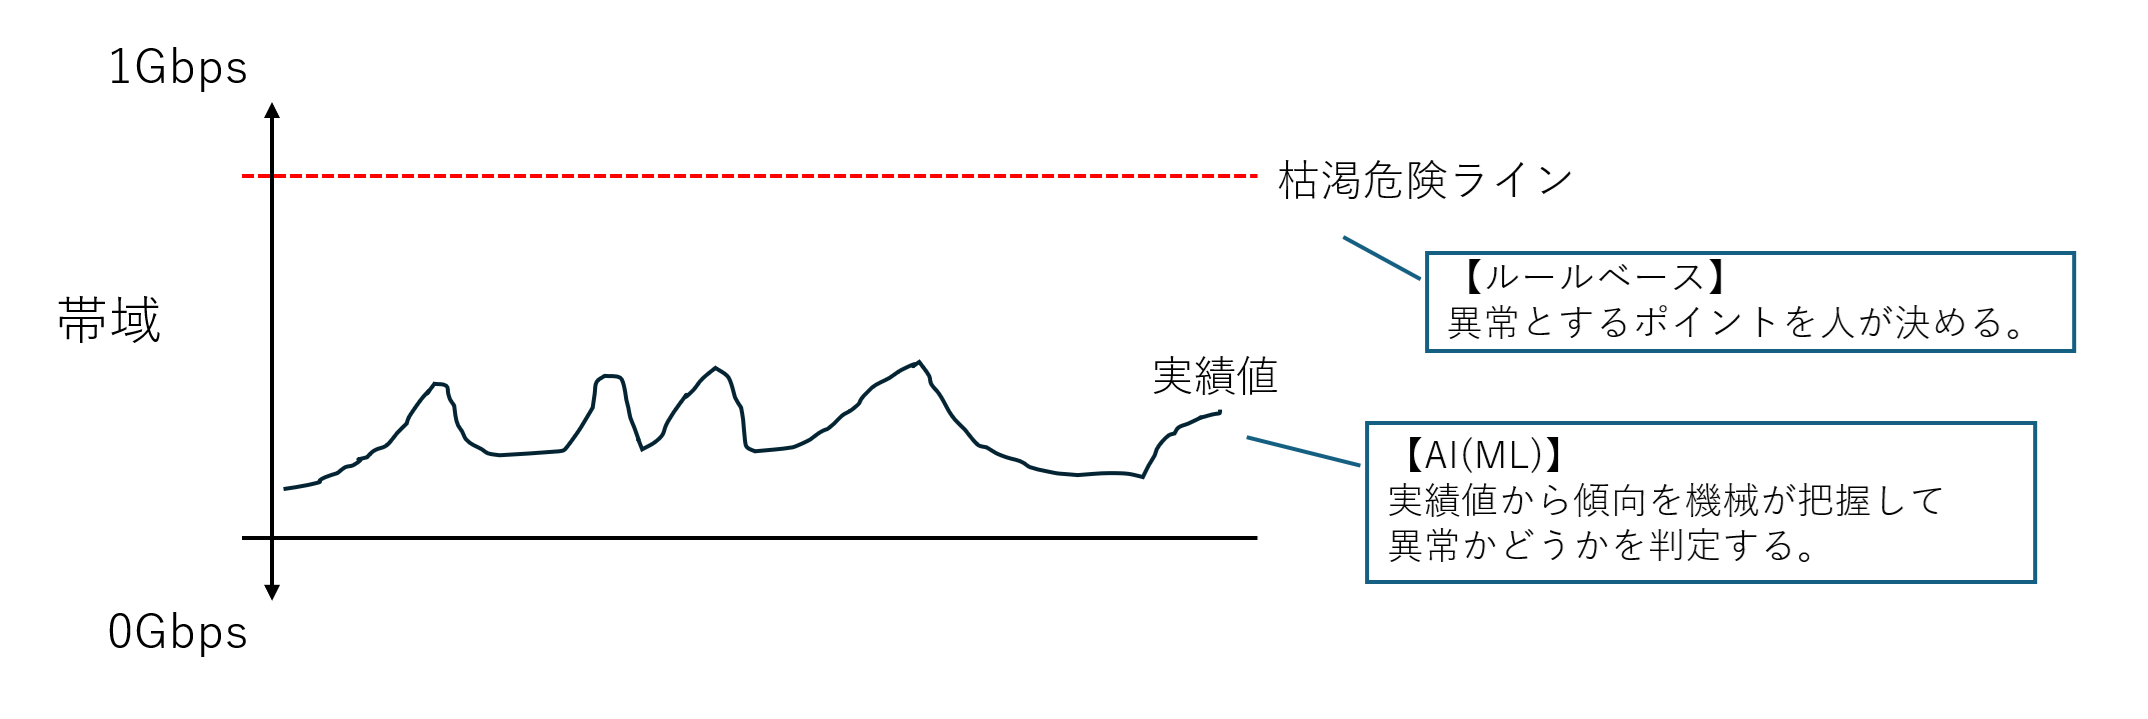
図6 ルールベースとAIによる異常検知の違い 今回はAIにより傾向外れを検知しますが、これによりルールベースでは定義していない/見つからない異常や異常につながる可能性(予兆)を見つけられる場合があります。 また、異常の判定方法にも「AIの予測と実績値が一定レベルでずれたら異常(覚えた傾向外れとなっている)」と判定する方法や「これまでの傾向や直近の値から、将来の値をAIで予測し問題となるラインを超えるか判定させる」方法などもあります。 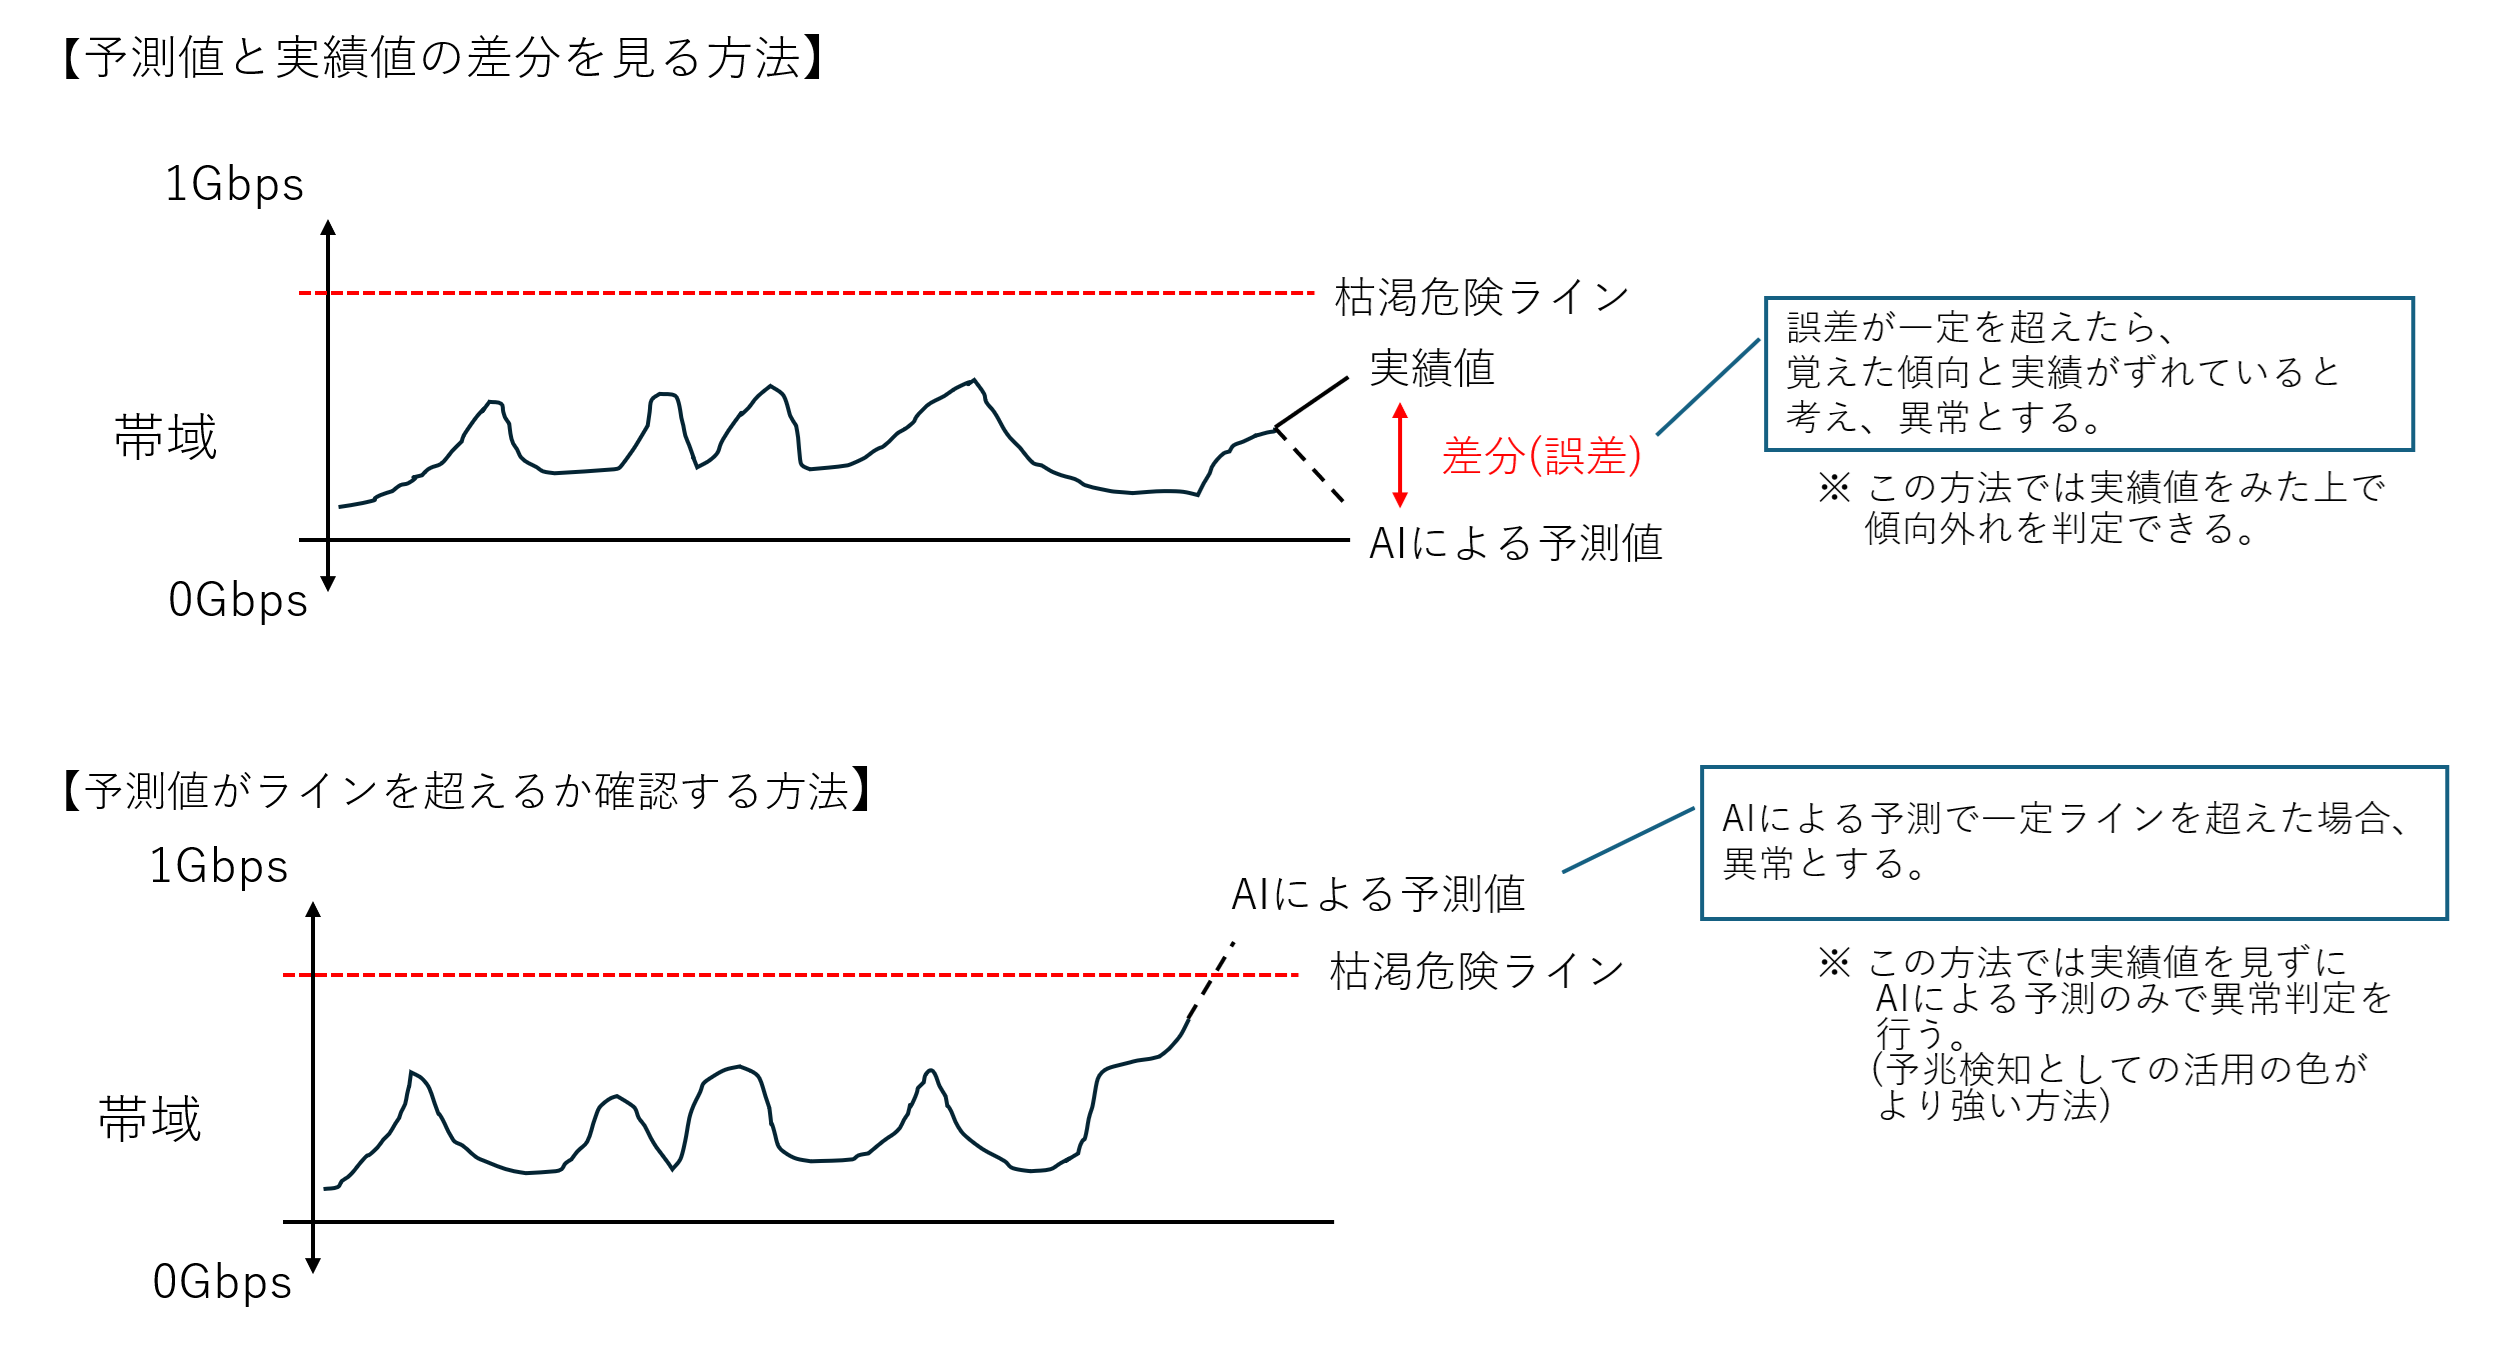
図7 AIによる異常判定方法の違い また、一見AIが便利そうにも見えますが、弱点もあります。 それぞれ一長一短あると思っていますので、併用してそれぞれの短所を補いながら長所を生かす運用をしていくことが理想と考えます。 |
|---|
構築環境と手順に関する前提
ここからは、「本連載で作る環境と検証シナリオ」章で紹介した環境と手順の前提を説明します。
手順の前提として各サーバはVMとし、仮想化ソフト上の設定手順(VMの定義/作成やVM間の内部NW作成など)は記載省略とします。
どの仮想化ソフトを使うかは、NW機器として扱うSONiC(VS版)がKVM上での利用が推奨されるため、KVM、あるいはKVMが使える仮想化ソフトで試せると良いかと思います。
本検証環境のNW構成は以下の通りとなります。
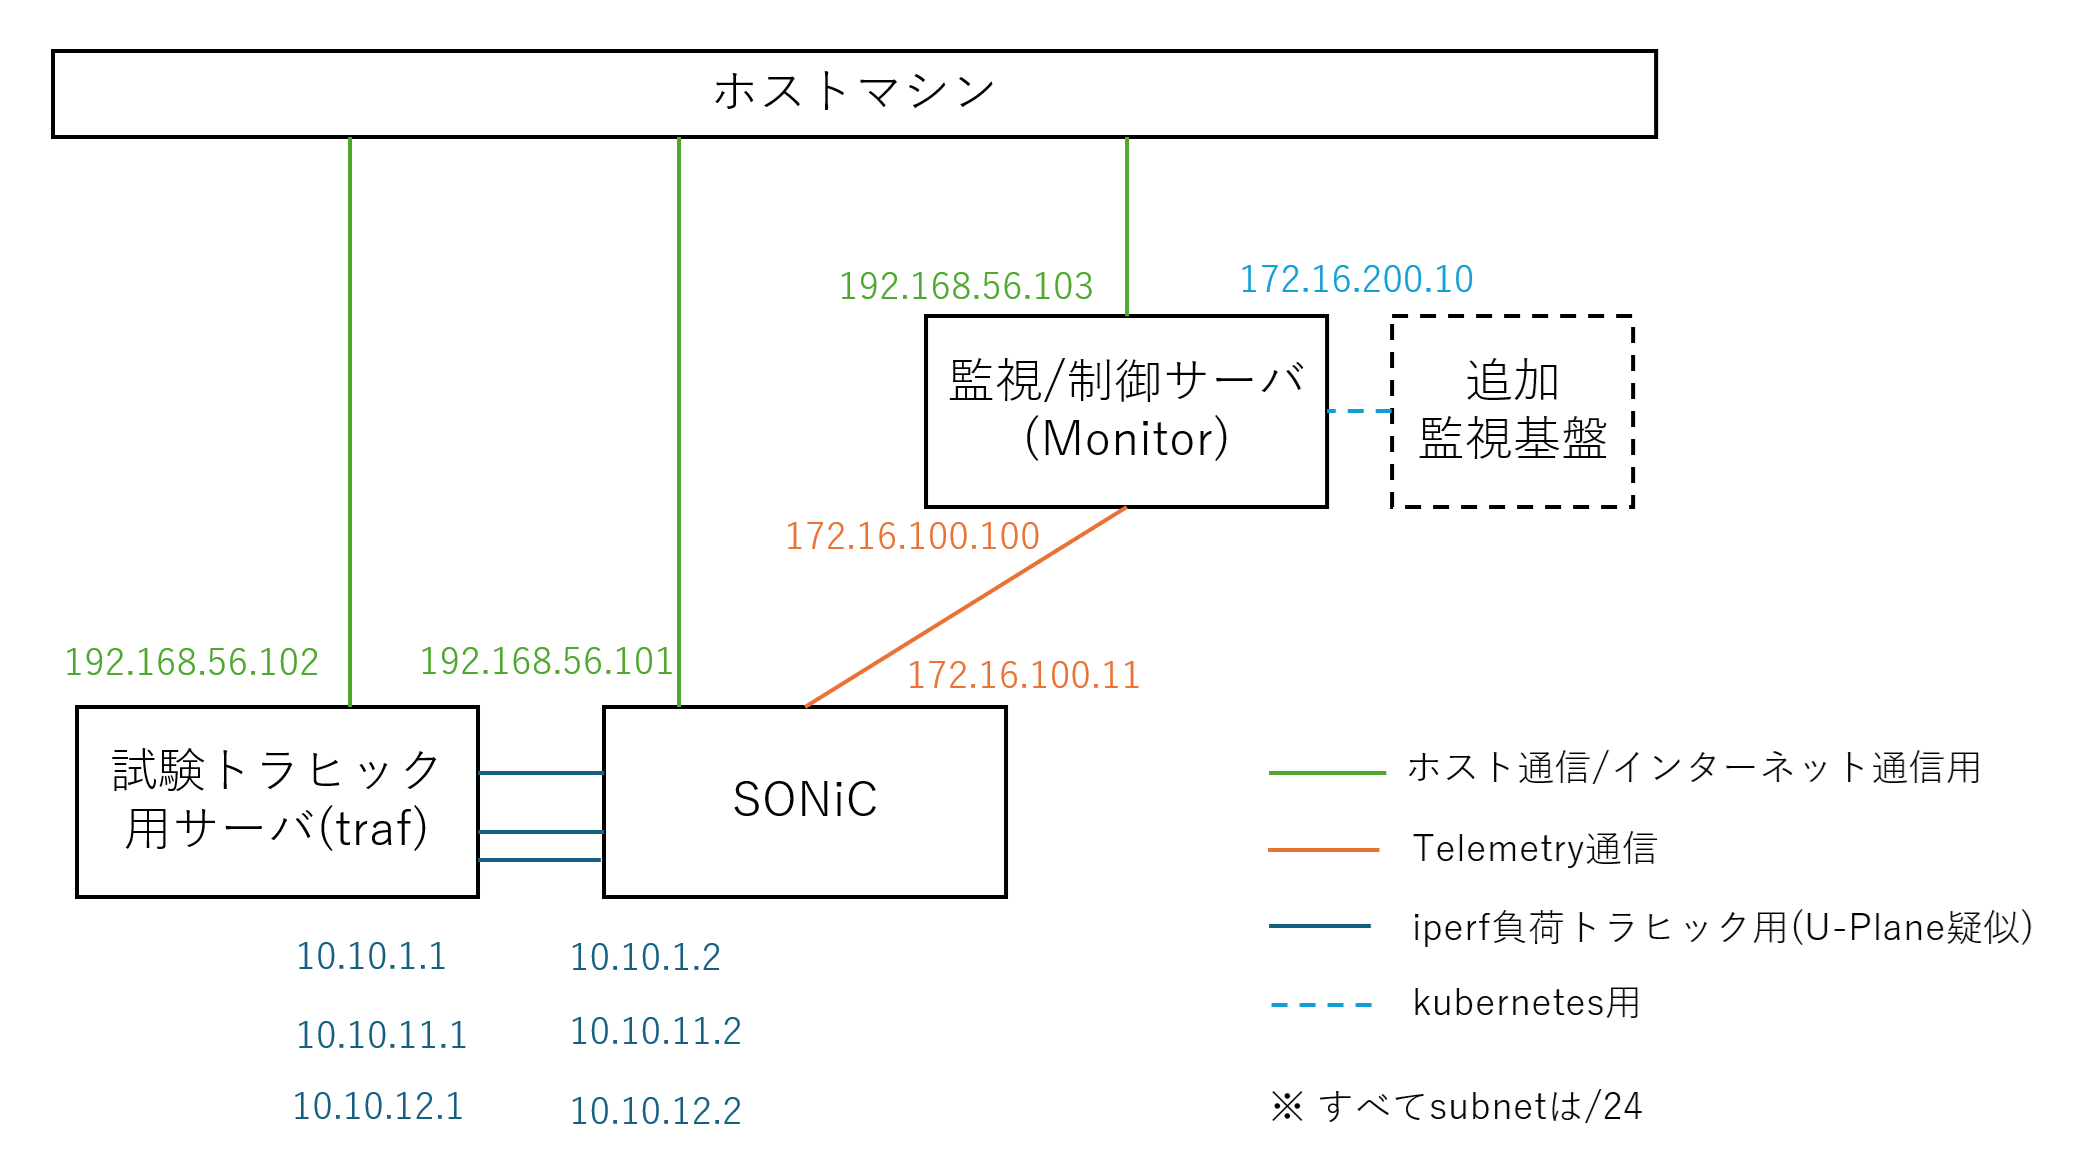
図8 全体NW構成
仮想化ソフト上で内部NWやVM上のIF数設定などを設定しておいてください。
VMに用意されたIF(NIC)にIPアドレスを設定し、起動する点は手順に含みたいと思います。
また、手順では途中でブラウザアクセスするものもありますが、これはVMからではなく、ホストマシンからブラウザでアクセスするものとします。
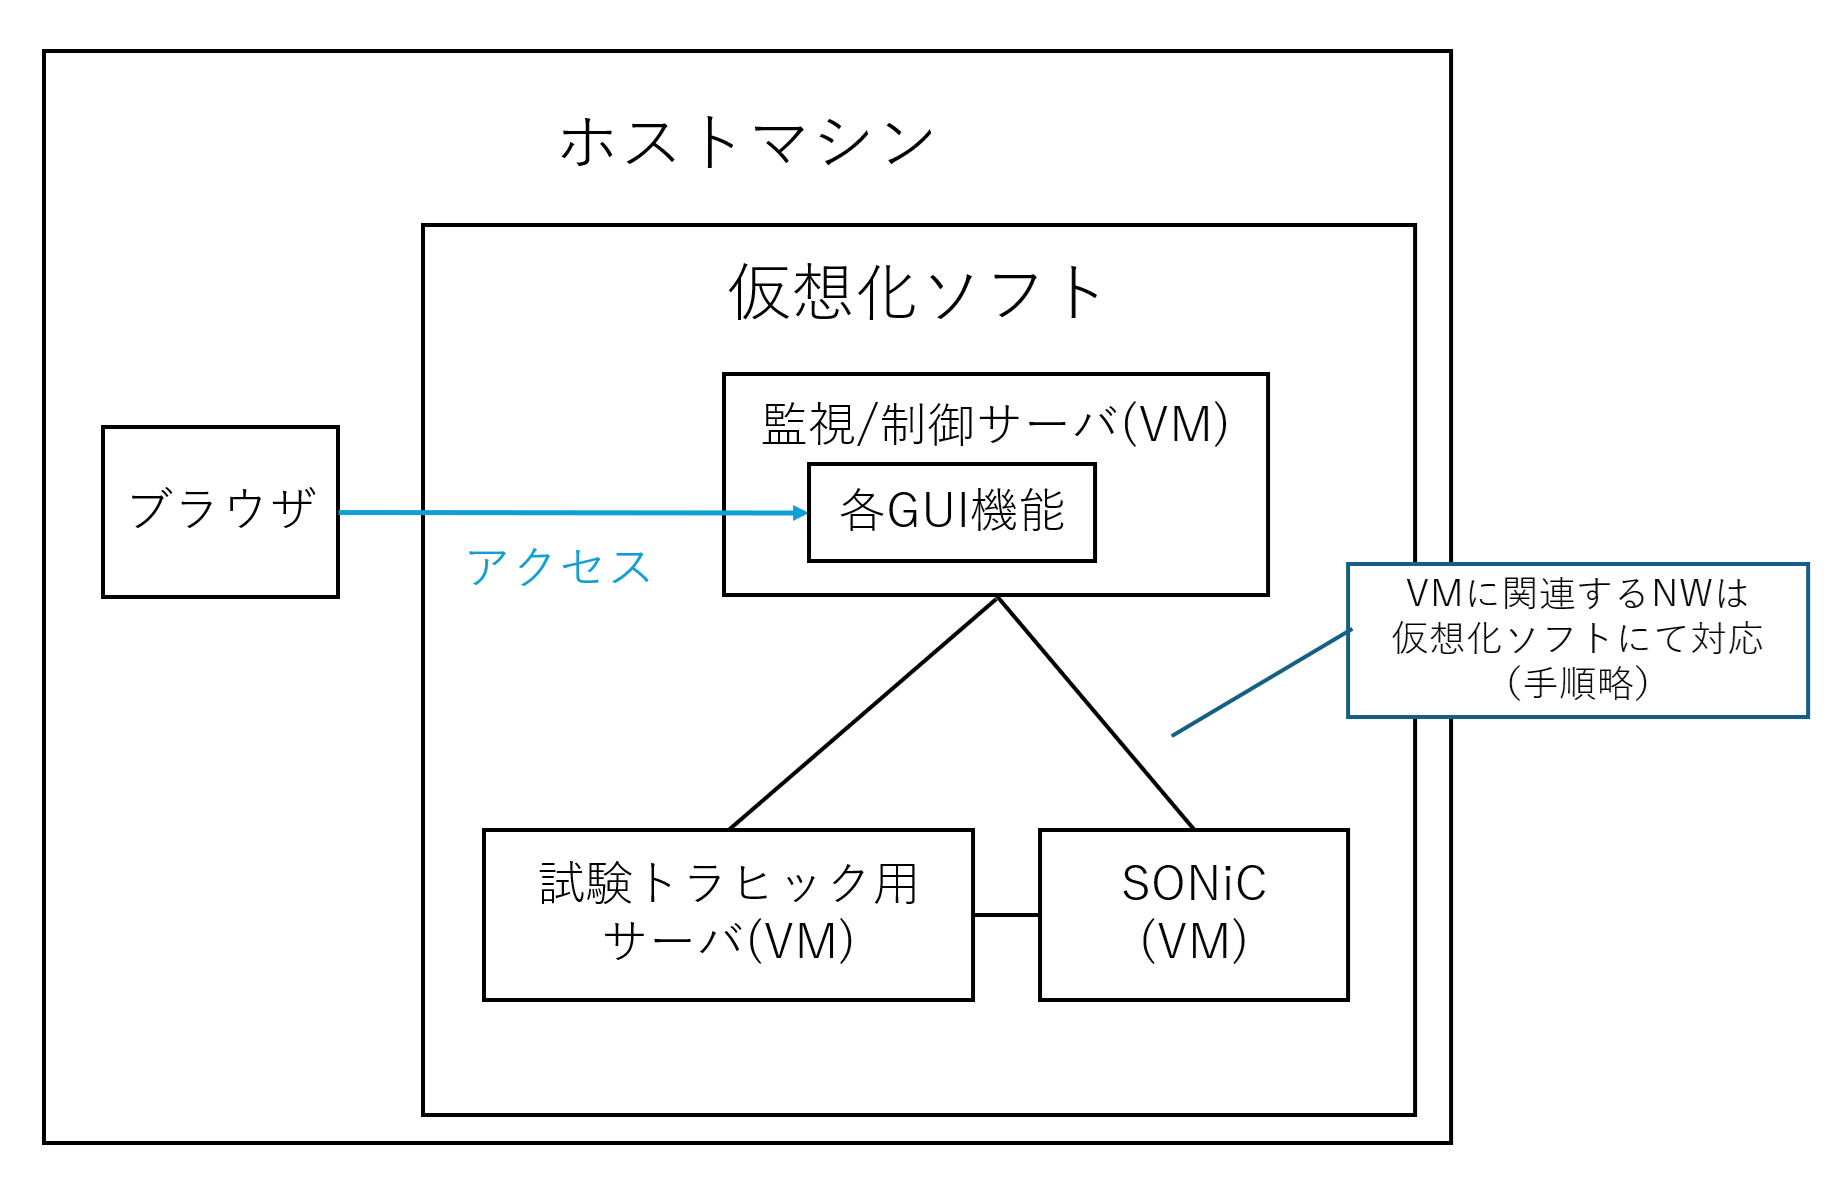
図9 前提のイメージ
各VMで最低限必要なリソース設定を以下に示します。
| VM | vCPU | Memory | IF |
|---|---|---|---|
| SONiC | 2 | 8GB | 5 |
| 試験トラヒック用サーバ(traf) | 2 | 4GB | 4 |
| 監視/制御サーバ(Monitor) | 8 | 16GB | 3 |
利用するOSやOSS/ツールのバージョンは以下の通りです。
| VM | VMのOSバージョン | 搭載ツール | ツールバージョン |
|---|---|---|---|
| SONiC | SONiC OS Version: 13 (VS版) |
- | - |
| 試験トラヒック用サーバ (traf) |
Ubuntu 24.04.4 LTS | iperf | iperf 3.16 |
| 監視/制御サーバ (Monitor) |
Ubuntu 24.04.4 LTS | k3s | v1.36.2+k3s1 |
| Telegraf | 1.39.1 | ||
| Prometheus | 3.13.0 | ||
| Grafana | 13.1.0 | ||
| Python | 3.12.3 |
Pythonプログラムで利用するライブラリのバージョンは以下の通りとなります。
| 利用場所 | ライブラリ名 | バージョン |
|---|---|---|
| AIによる判断と制御基盤 | numpy | 2.5.1 |
| pandas | 3.0.3 | |
| paramiko | 5.0.0 | |
| requests | 2.34.2 | |
| xgboost | 3.3.0 | |
| LLMによる問い合わせ 支援基盤 |
Streamlit | 1.59.2 |
| openai | 2.45.0 |
完成した環境での検証結果概要
本連載で扱う環境ができるとどんなことができるのかをもう少しイメージできるように、実際の実行例を一部示します。
※ 細かい検証の流れや結果は「第5回」にて紹介します。
ここで紹介するのは、図3のNo.1~6まで完了した際の状態です。
すはわち「NW機器(SONiC)に流入するトラヒック量が通常時から急激に増え、それをAIが異常(傾向外れ)と判定し、自動で経路切り替えを実施した後」の監視/可視化基盤の画面を紹介します。
以下がその画面です。
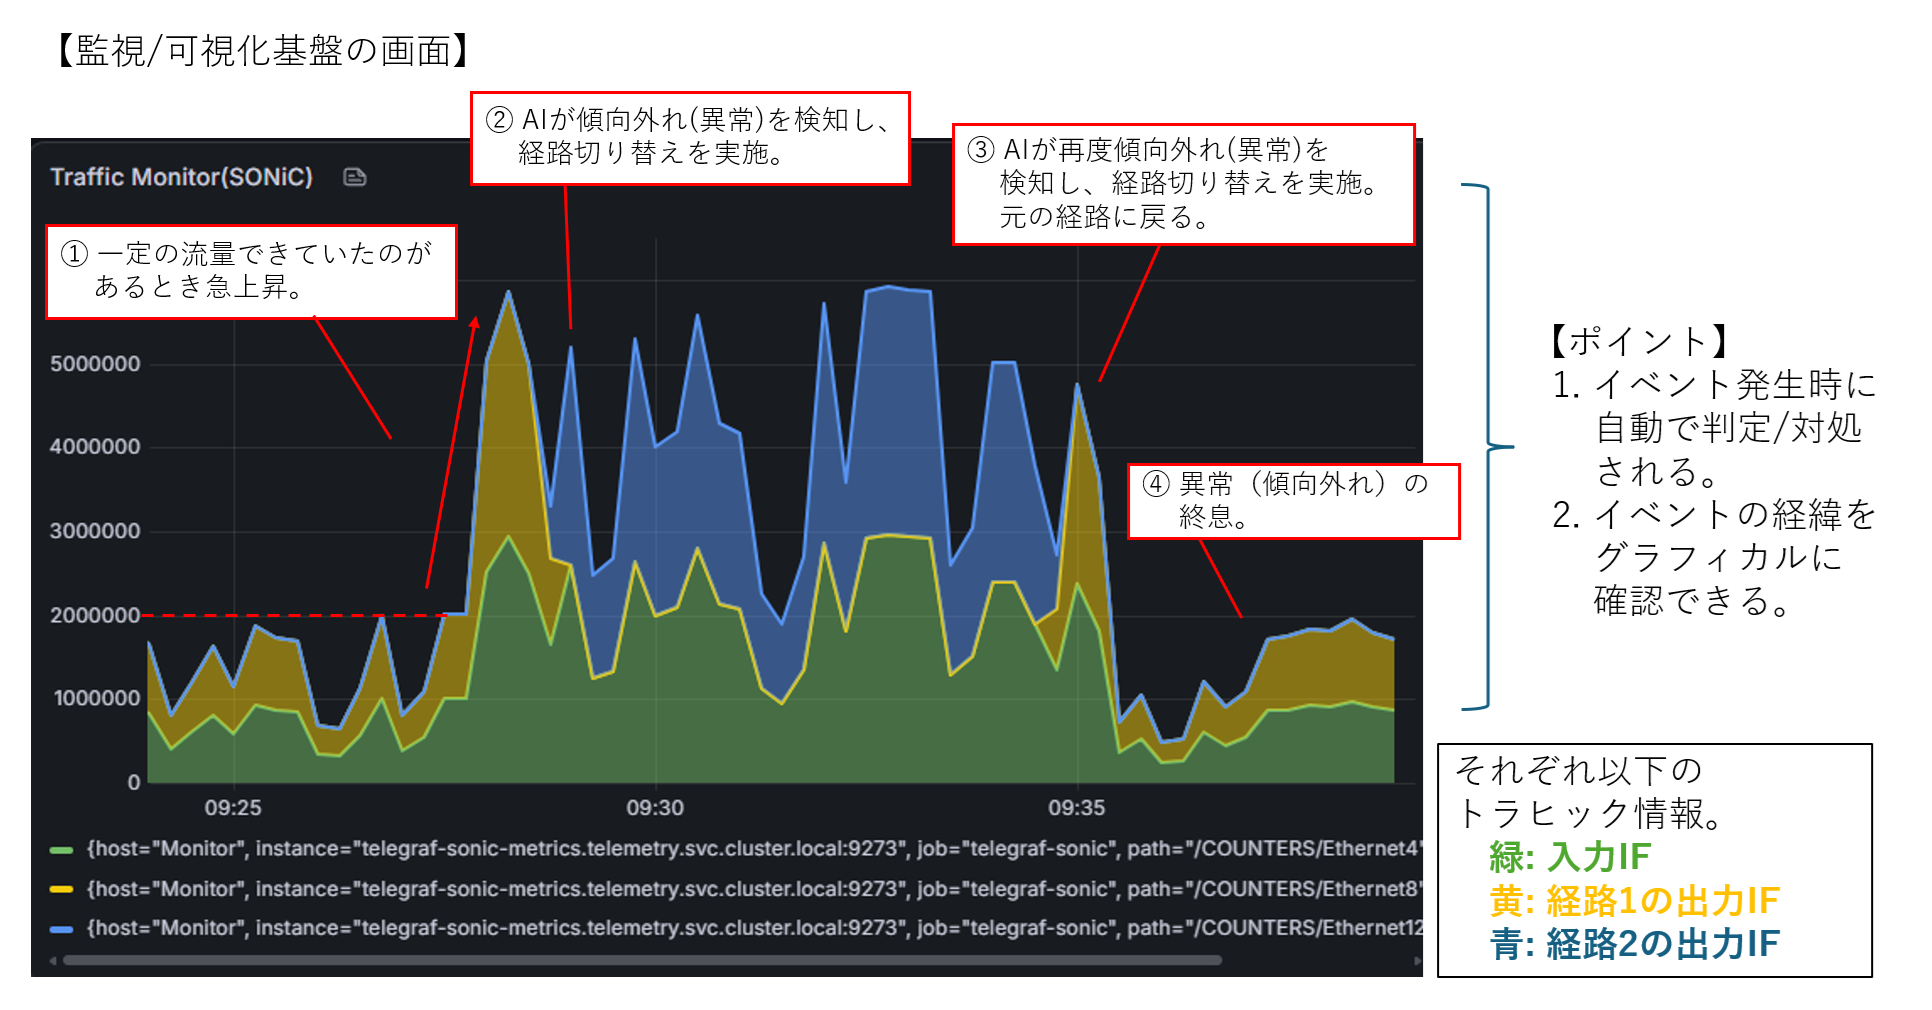
図10 作成した環境での検証結果概要(一部)
「AIによる判断と制御基盤」による経路切り替えも含めたイベントの経緯がわかりやすく追えるのがわかるのではないかと思います。
なお、上記の画面には現れませんが、図3 No.7にあたる箇所である「LLM問い合わせ支援基盤」で異常と判定された理由をLLMに問い合わせし、「原因の早期把握」の例は第5回でお見せできれば、と思っています。
前述の通り最終的には検証手順と結果については第5回で紹介しますが、それまでに環境の構築手順/動作例なども要所要所で示すので、内部的にどのように動いているのかおさえながら最後の検証結果を確認できるとより良いかと思います。
おわりに
今回は本記事を含めた5回で構築する環境の全体像や作った環境で試すシナリオといった概要について紹介しました。
本連載で扱う技術はSONiCやTelemetry、Kubernetes、AIなど幅広いものとなる為、次回以降の構築手順などで1つ1つをしっかりおさえられればと思います。
次回は「NW層の実現」と「各VMの設定」について紹介したいと思います。
最後までご覧いただきありがとうございました。
もし何かご意見・コメント・ご質問などがあれば、以下からお問い合わせください。
本件に関するお問い合わせ
<<<<著者プロフィール>>>>
フューチャーネットワーク事業部
第一ビジネスユニット
山口 佳輝(YAMAGUCHI YOSHIKI)
NWに関係したシステム開発を担当しています
>>>>>>>>><<<<<<<<<