SONiCとTelemetry, AIで作るクローズドループ基盤(4) ~AIによる判断と制御基盤編~
本シリーズではSONiCとTelemetry, AIを用いたクローズドループ基盤について紹介します。本記事ではXGBoostを用いた異常判断とSONiCへの設定投入について扱います。


テクノロジーコラム
- 2026年10月15日公開
はじめに
こんにちは、NTTテクノクロスの山口です。
本連載では、SONiCとTelemetry、AIを活用した簡易なクローズドループ基盤の構築とその動作例について紹介します。
前回の記事までで、クローズドループ環境の「NW」と「監視/可視化基盤」の構築ができました。
今回はNW機器から収集したデータをAIに渡すことで異常を判定し、設定を投入する「AIによる判断と制御基盤」の構築手順と関連技術の紹介をしたいと思います。
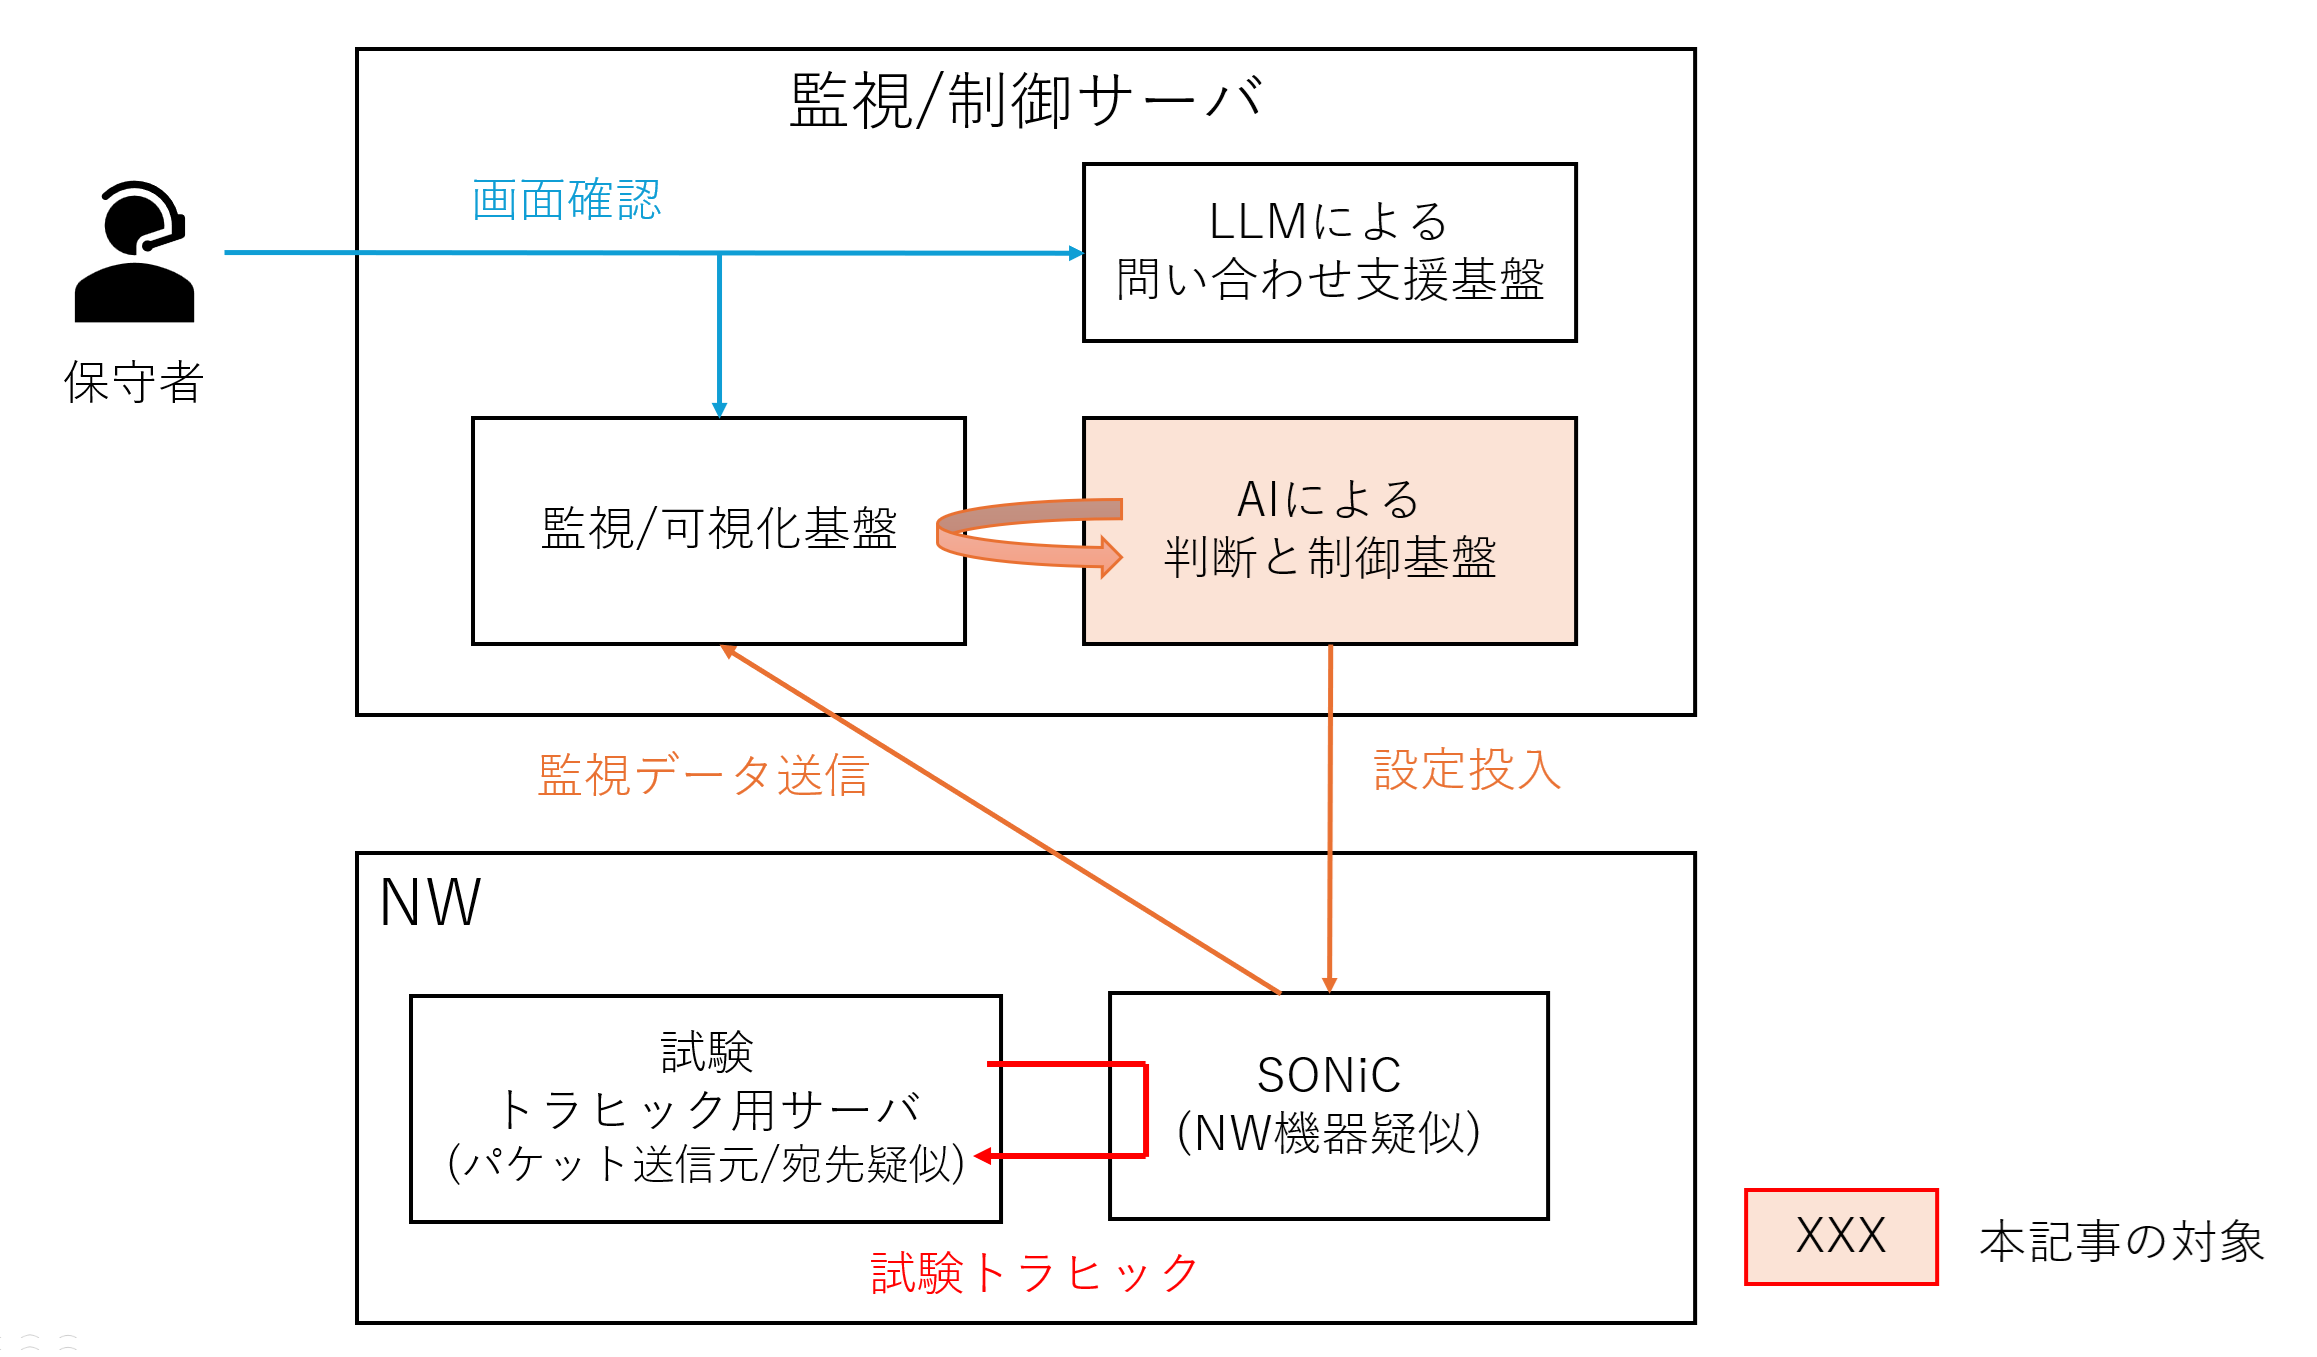
図0-1 全体像の概要と本記事の範囲概要
各ツールを連動させて動かす(結合観点)のは第5回(次回)で扱うこととし、本記事では利用するツールの準備とツール単体の動作確認まで紹介します。
また、今回もこれまでと同様に随時補足もいれていきます。
こちらは参考情報程度である為、気になる方はご確認いただければ、と思います。
本編と補足も踏まえて、周辺技術などについて理解の助けとなれば幸いです。
なお、必ずしもこれまでの記事のすべてを確認いただく必要はありませんが、必要に応じて参照いただけると良いかと思います。
| 記事 | 章 | 節 | 項 |
|---|---|---|---|
| 第1回 | クローズドループとは | - | - |
| 本連載で作る環境と検証シナリオ | - | - | |
| 構築環境と手順に関する前提 | - | - | |
| 完成した環境での検証結果概要 | - | - | |
| 第2回 | 環境の作り方 (各サーバ設定) |
1. 全体像 | - |
| 2. SONiC | - | ||
| 3. 試験トラヒック用サーバ | - | ||
| 4. 監視/制御サーバ | - | ||
| 第3回 | 環境の作り方 (監視/可視化基盤) |
1. 全体像と全体設定 | - |
| 2. Telegraf | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 3. Prometheus | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 4. Grafana | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 【補足】 5. Prometheusによる ルールベース異常判定の準備 |
A. 設計・方針整理 | ||
| B-1. 構築手順(ルール定義) | |||
| B-2. 構築手順(Prometheus) | |||
| B-3. 構築手順(Alertmanager) | |||
| C. 起動と動作確認 | |||
| D. その他 | |||
| 第4回 (今回) |
環境の作り方 (AIによる判断と制御基盤) |
1. 全体像 | - |
| 2. AI利用に関する設計と事前準備 | ① AIに関する設計 | ||
| ② データの収集 | |||
| ③ AIの学習用データの選定/抽出 | |||
| 3. 学習ツール | ④ データの加工(前処理)~ ⑥ 精度確認(モデルの評価) |
||
| 4. 推論ツール | ⑦ AIモデルの利用(推論) | ||
| 5. 経路切り替えツール | - | ||
| 6. 定期実行の実現 | - | ||
| 第5回 | 環境の作り方 (LLMによる問い合わせ支援基盤) |
1. 全体像 | - |
| 2. チャット機能 | A. 構築・起動手順 | ||
| B. 動作確認 | |||
| 検証シナリオの実施と結果 | 1. AIを用いたクローズドループ環境検証 | Ⅰ. 手順概要 | |
| Ⅱ. 手順実施と結果 | |||
| 【補足】 2. ルールベース異常判定の検証 |
Ⅰ. 手順概要 | ||
| Ⅱ. 手順実施と結果 |
※ 本記事の内容を用いた開発・運用は、必ずご自身の責任と判断によって行ってください。
開発・運用の結果について、いかなる責任も負いません。
環境の作り方(AIによる判断と制御基盤)
1. 全体像
今回は「監視/制御サーバ」上に配置する「AIによる判断と制御基盤」について扱います。
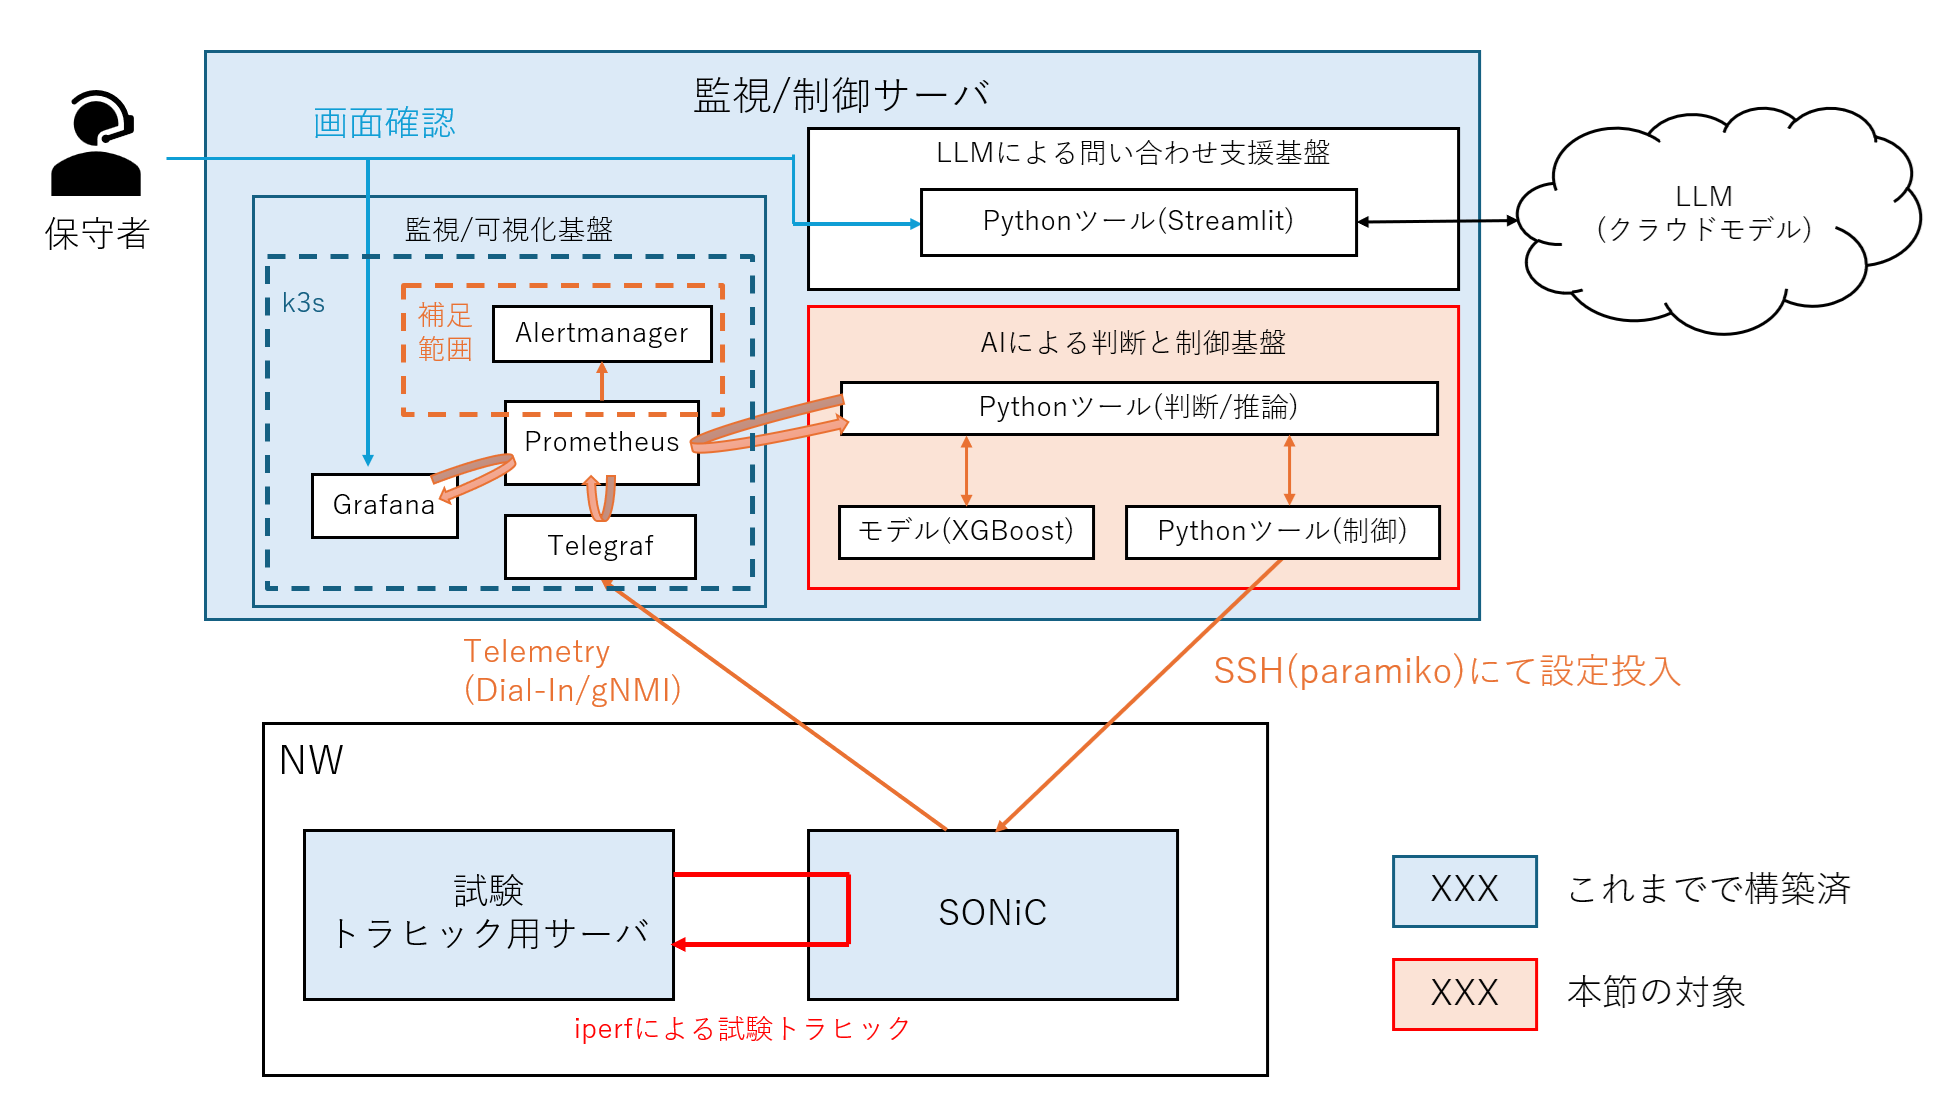
図1-1 本節の対象
前提として、「NW部(SONiC/試験トラヒック用サーバ)」の構築、「監視/制御サーバ」の設定や「監視/可視化基盤」の構築は実施済であることとします。(第2回、第3回参照)
利用するライブラリのバージョンなどは第1回の「構築環境と手順に関する前提」章を参照ください。
処理の概要としては、「Pythonツール(推論/判断)」が、第3回で用意した監視/可視化基盤のPrometheusから直近の情報を取得し、「AI(モデル(XGBoost))」を使用して異常(傾向外れ)かどうかを判定します。
異常と判定された場合には、「Pythonツール(制御)」が連動し、SONiCに対して経路切り替えの設定を行います。
AIは、SONiCのトラフィック情報を基に異常の有無を判定します。
そのため、あらかじめSONiCのトラフィック情報を学習させたAIモデルを準備する必要があります。
このAIモデルは、学習ツールを用いて作成します。
つまりAIによる判断と制御基盤を動かすためには、以下の3つのツールが必要になります。
| ツール名 | 説明 |
|---|---|
| 学習ツール | 異常判定を行うAIを用意するツール。 |
| 推論ツール | 用意されたAIを呼び出し、異常の場合は経路切り替えツールを呼び出すツール。 図1-1でいう「Pythonツール(推論/判断)」。 |
| 経路切り替え ツール |
AIが異常と判定した場合に、その対策としてSONiCの経路を切り替えるツール。 図1-1でいう「Pythonツール(制御)」。 |
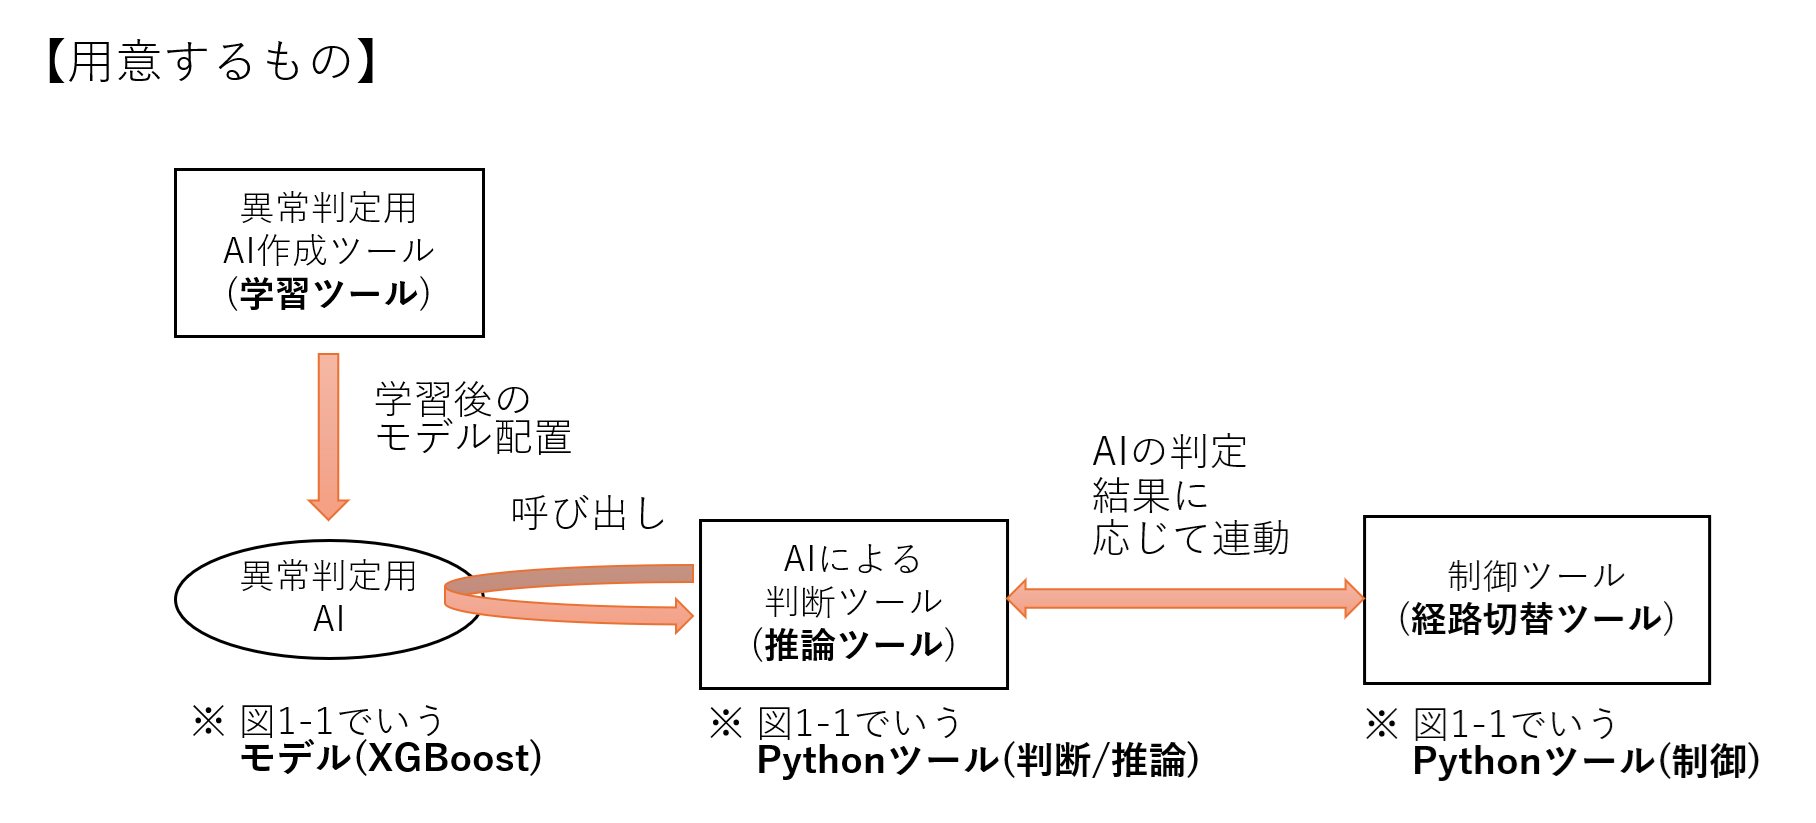
図1-2 用意するものの構成イメージ
あわせて考えたいのが、これらのツールをどのように準備していくか、です。
AIを利用するには、設計から推論(AI利用)までに様々な各ステップが存在します。
AI利用までの全体の流れと、各ステップで使用するツールを以下に示します。
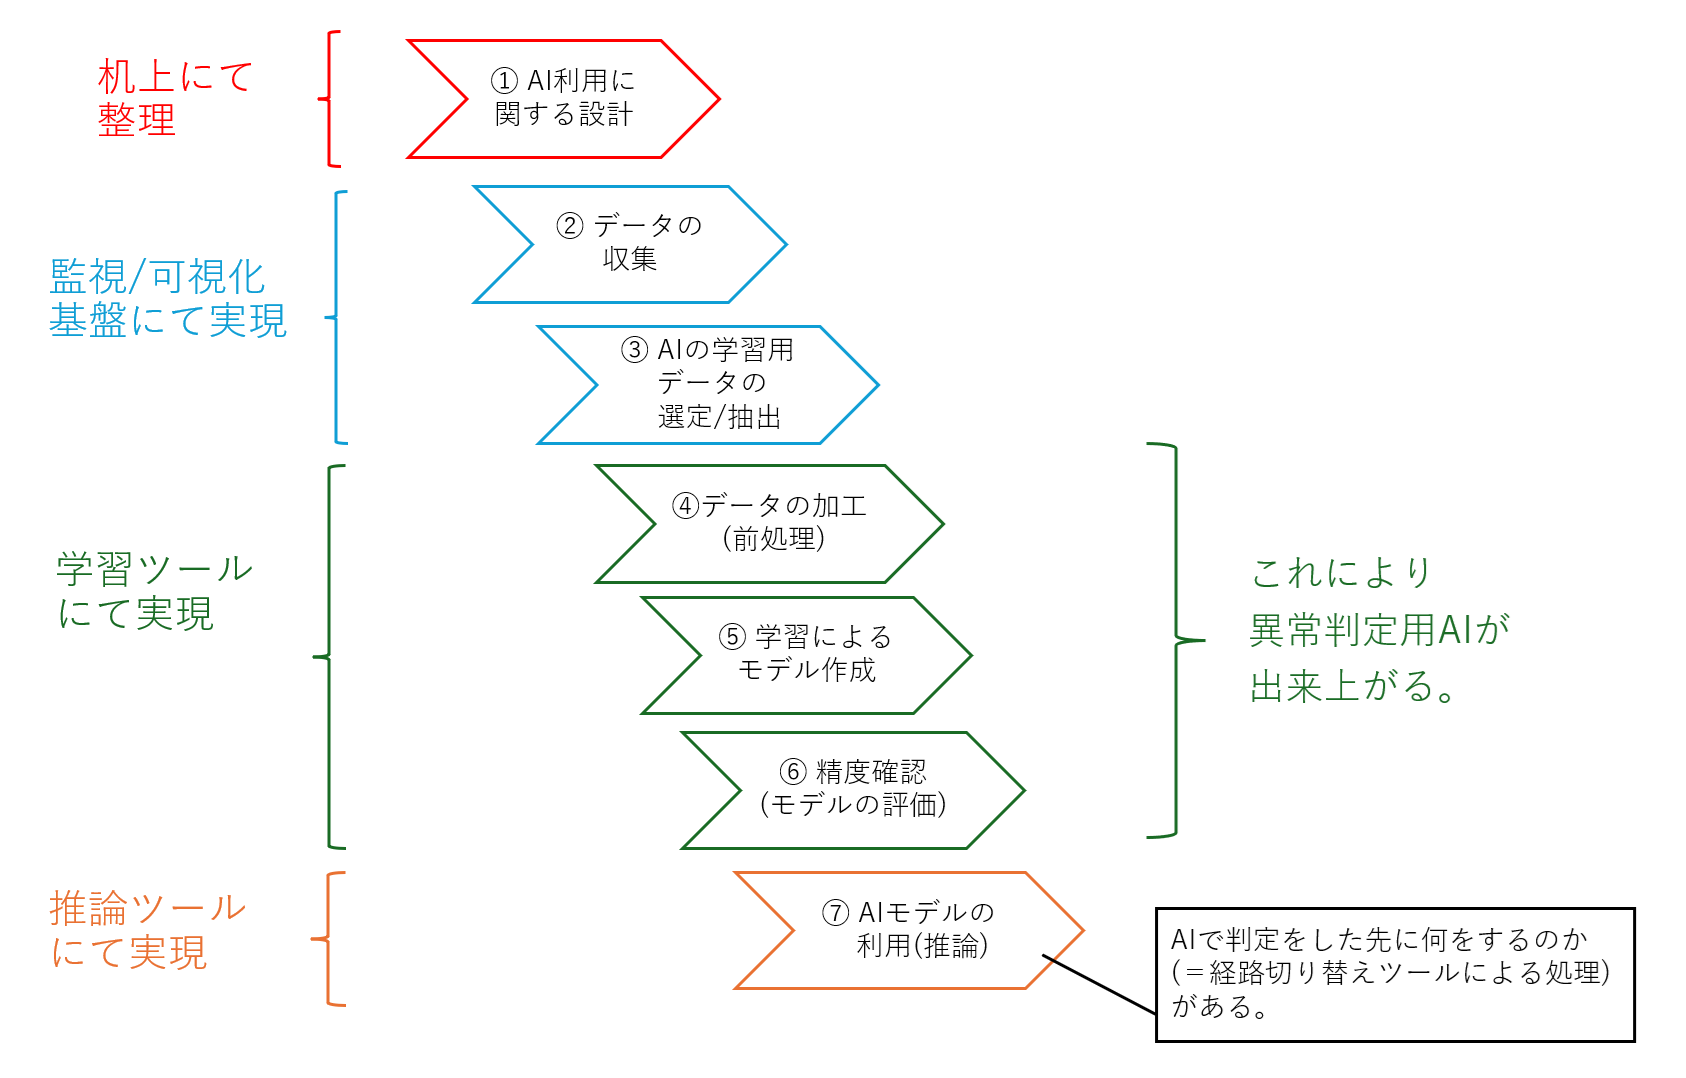
図1-3 AI利用を進めるためのステップと本連載での実現箇所
ステップに応じて、必要なツールや機能を整理/準備することが重要です。
今回は上のステップ論を当てはめながら「AI利用に関する設計と事前準備」→「各ツール(学習ツール, 推論ツール, 経路切り替えツール)」の順で紹介します。
2. AI利用に関する設計と事前準備
① AI利用に関する設計
ここでは以下のような流れに沿って、実現したい事や利用する手法、AI利用に伴う運用の整理などを行います。
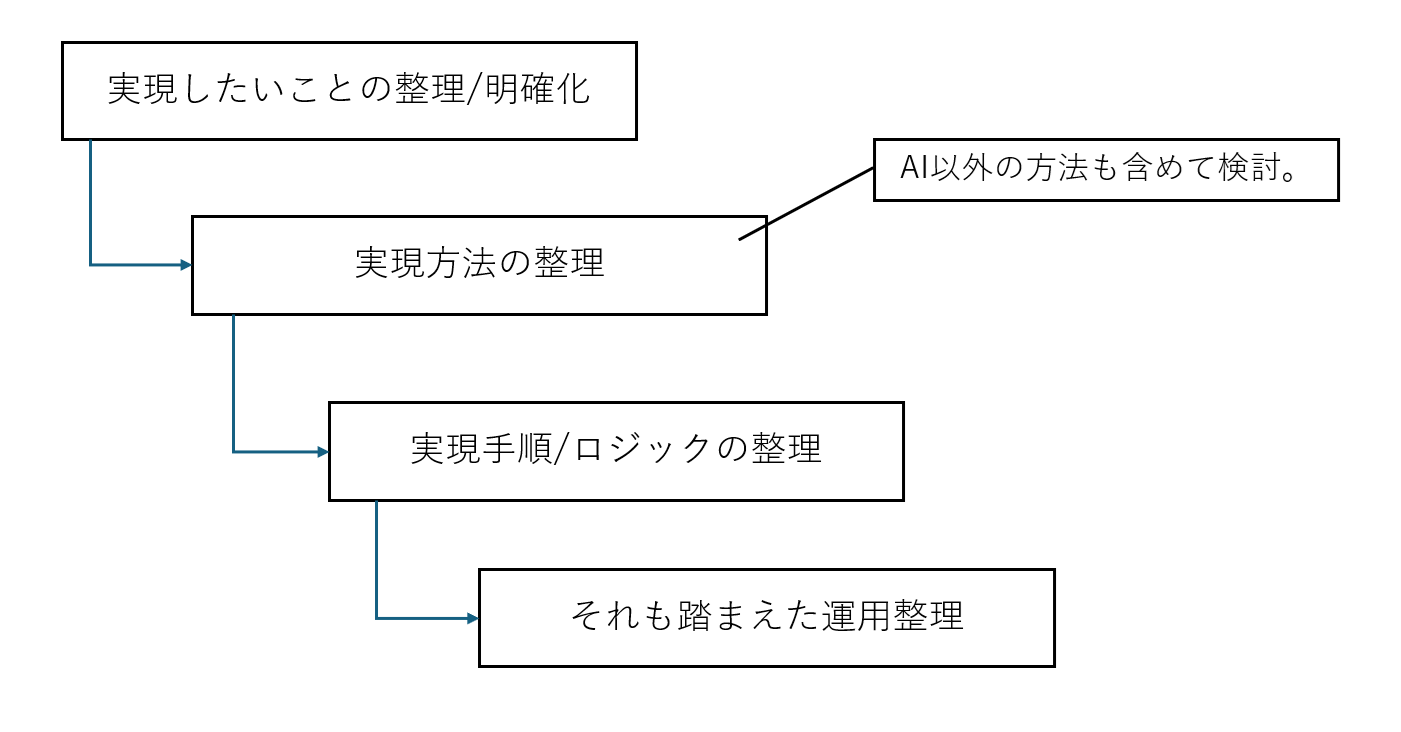
図2-1 整理の流れ
まず重要なポイントは、AIは実現したいことを達成するための手段でしかない為、最初から手段ありき(AI利用ありき)で考えるのは避けるべきという点です。
「実現したいことに対して、AIという手段を利用する」と決まってはじめて「AI利用の設計(=実現手順/ロジックの整理以降)」に入ります。
今回はAIの導入フローも少しイメージできるように、「AI利用の設計」よりも、もう少し前段の流れ(実現したいことの整理/検討)から紹介していきたいと思います。
実現したいことの整理/明確化
まずは「何を実現したいか」を決めていきます。
最初は大雑把で構いません。
最初に決めた「実現したいこと」に対し、この後の整理も含め詳細化/精緻化していきます。
今回の記事では「NW機器(SONiC)のトラヒック量をチェックし、不穏な状態や動作となったら異常と判定したい」が実現したいことです。
実現方法の整理
次に「実現したいこと」をどう達成するかを考えます。
ここでAIを利用するか、あるいはほかの手段を利用するか決めます。
前述の通りAIはあくまで手段なので、他の手段やその特性なども踏まえて、どう実現したいかを決めていきましょう。
例えば今回の例では「不穏な状態とは、どのような状態なのか」を定義できれば、ルールベースの異常検知でも実現できるでしょう。
ただ今回はルールに該当しないような、あるいはルールで定義していない/できないような不穏な状態や動作を見つけることを期待し、AIを活用する方針に整理したとします。
※ ルールベースとAIの使い分けについては「第1回」もご参照ください。
実現手順/ロジックの整理
実現方法(AIを使う)が決まったら、次はどのように「不穏な動作」を見つけていくか(AIをどう使うのか)を整理します。
ここからが「AI利用に関する設計」といってよいでしょう。
今回は「通常時の傾向を把握し、ここから外れた場合は異常かもしれない」と考え、「傾向外れを検知する」方法でこれを実現するものとします。
「傾向外れ」をどのように見つけるかというと、トラヒック量に関するAIモデルの予測値と実績の差(予測誤差)を確認し、一定以上の乖離が出た場合に異常と判定する方法をとります。
言い換えると、AIが学習したこれまでの傾向から「次は大体これぐらい」と予測をしますが、実績値が予測と大きくズレた場合、「これまでの傾向と異なる」といえる為、異常と判定します。
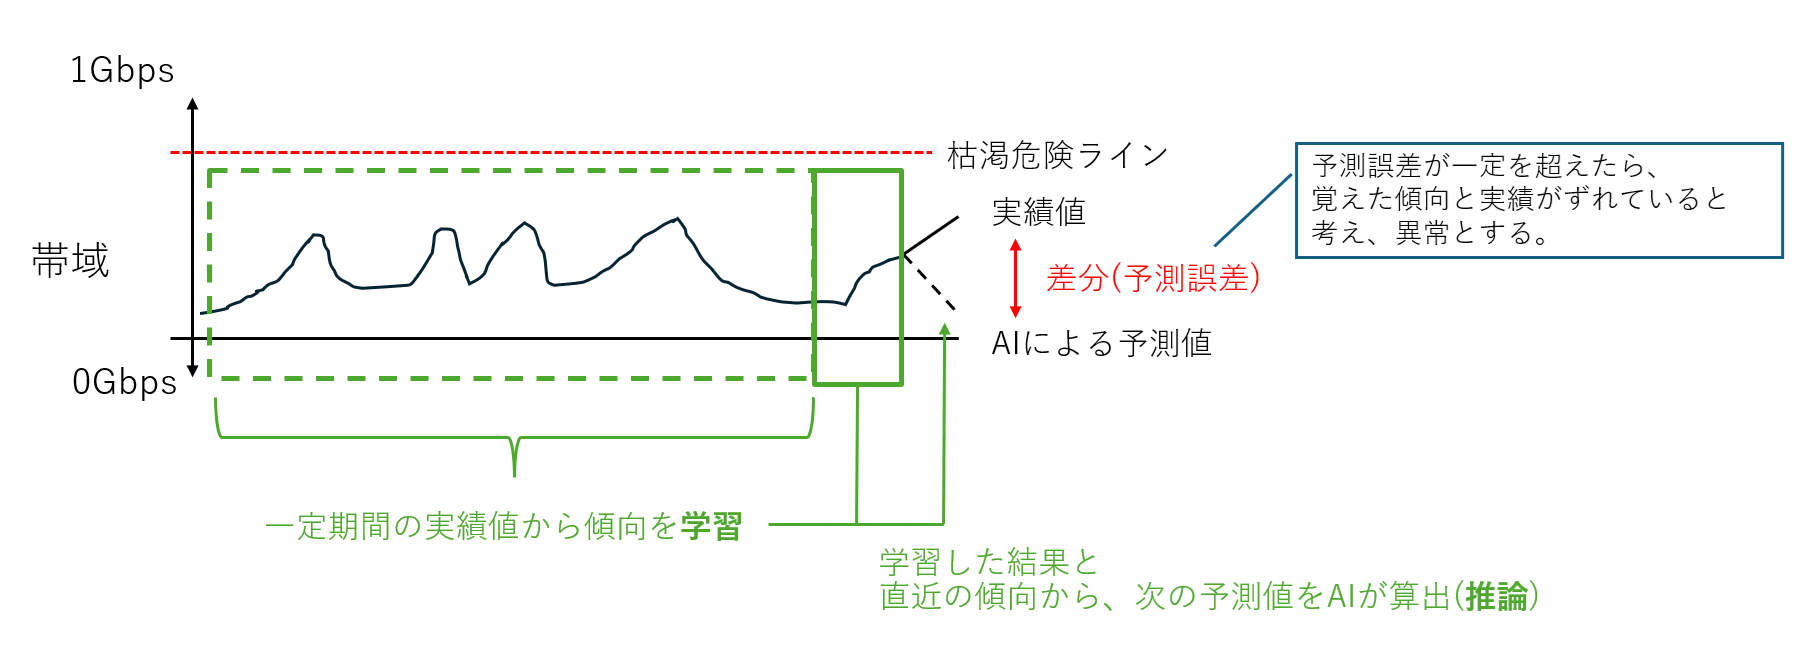
図2-2 AIによる異常判定のイメージと学習/推論について
あわせて利用するAIロジックを検討します。
今回はXGBoostを利用します。
XGBoostとは、AI/MLロジック(機械学習手法)の1つで、回帰タスク(連続値を予測する)と分類タスクの両方に適用できる手法です。
今回はトラヒック流量の連続値を扱う為、回帰処理を利用します。
XGBoostの特徴としては比較的精度が高くなりやすいといわれる点と拡張性の高さです。
後者については、例えば今回の例では(時間の推移とあわせた)トラヒック量だけを利用して予測を行いますが、他にもCPU使用率やパケットのドロップ数など、複数の要素を組み合わせて異常判定したい場合にも対応可能です。
また、欠損値(特定の時間帯だけ値がない)がある場合でもそれを考慮して学習や予測が行えます。
NW監視においては、NW機器が必要なデータを出してこない場合や途中の経路やコンポーネントでロスしてしまうケースも考えられるため、欠損値を意識できる、という点は極めて魅力的なポイントといえます。
| [補足2-1] MLとLLMの違い 昨今LLMの能力が極めて高くなってきています。 仕組み的な話をするとLLMは「大規模言語モデル」の名前の通り「言語」の生成が得意なモデルです。 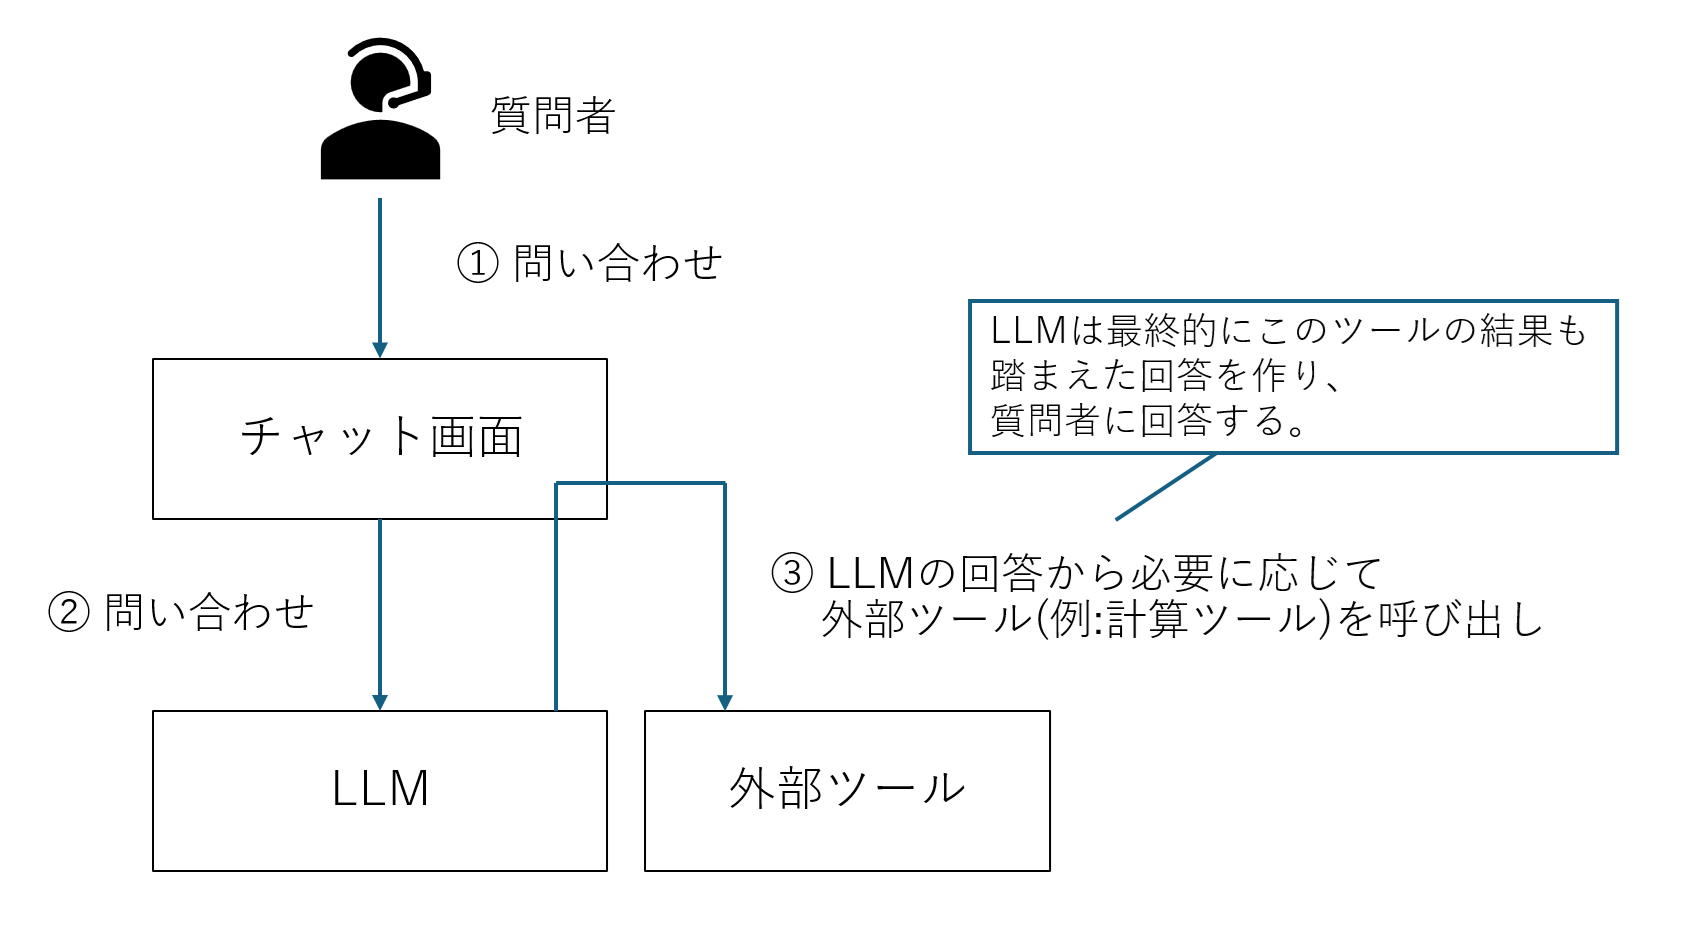
図2-3 AIエージェントのイメージ(概要) イメージ的にはLLMを人と見立てた時、人が頭の中で計算をするのではなく電卓を使っているようなものです。 LLMが外部ツールやプログラム実行をどこまでできるかは、AIエージェントやその基盤によるものが大きく、不確実性も高い上、モデル学習に使う大量のデータを都度AIエージェントに送り付けたり推論の度にLLMを挟むのも効率的とは言えません。 ちなみにLLMが得意としている文章生成については、「問い合わせ支援基盤」でチャットボットとして利用します。 |
|---|
XGBoostで作るAI(回帰モデル)がどうような構造やロジックをしているのかについても簡単に紹介します。
XGBoostは決定木と呼ばれる判断構造とその結果を組み合わせて実現される手法です。
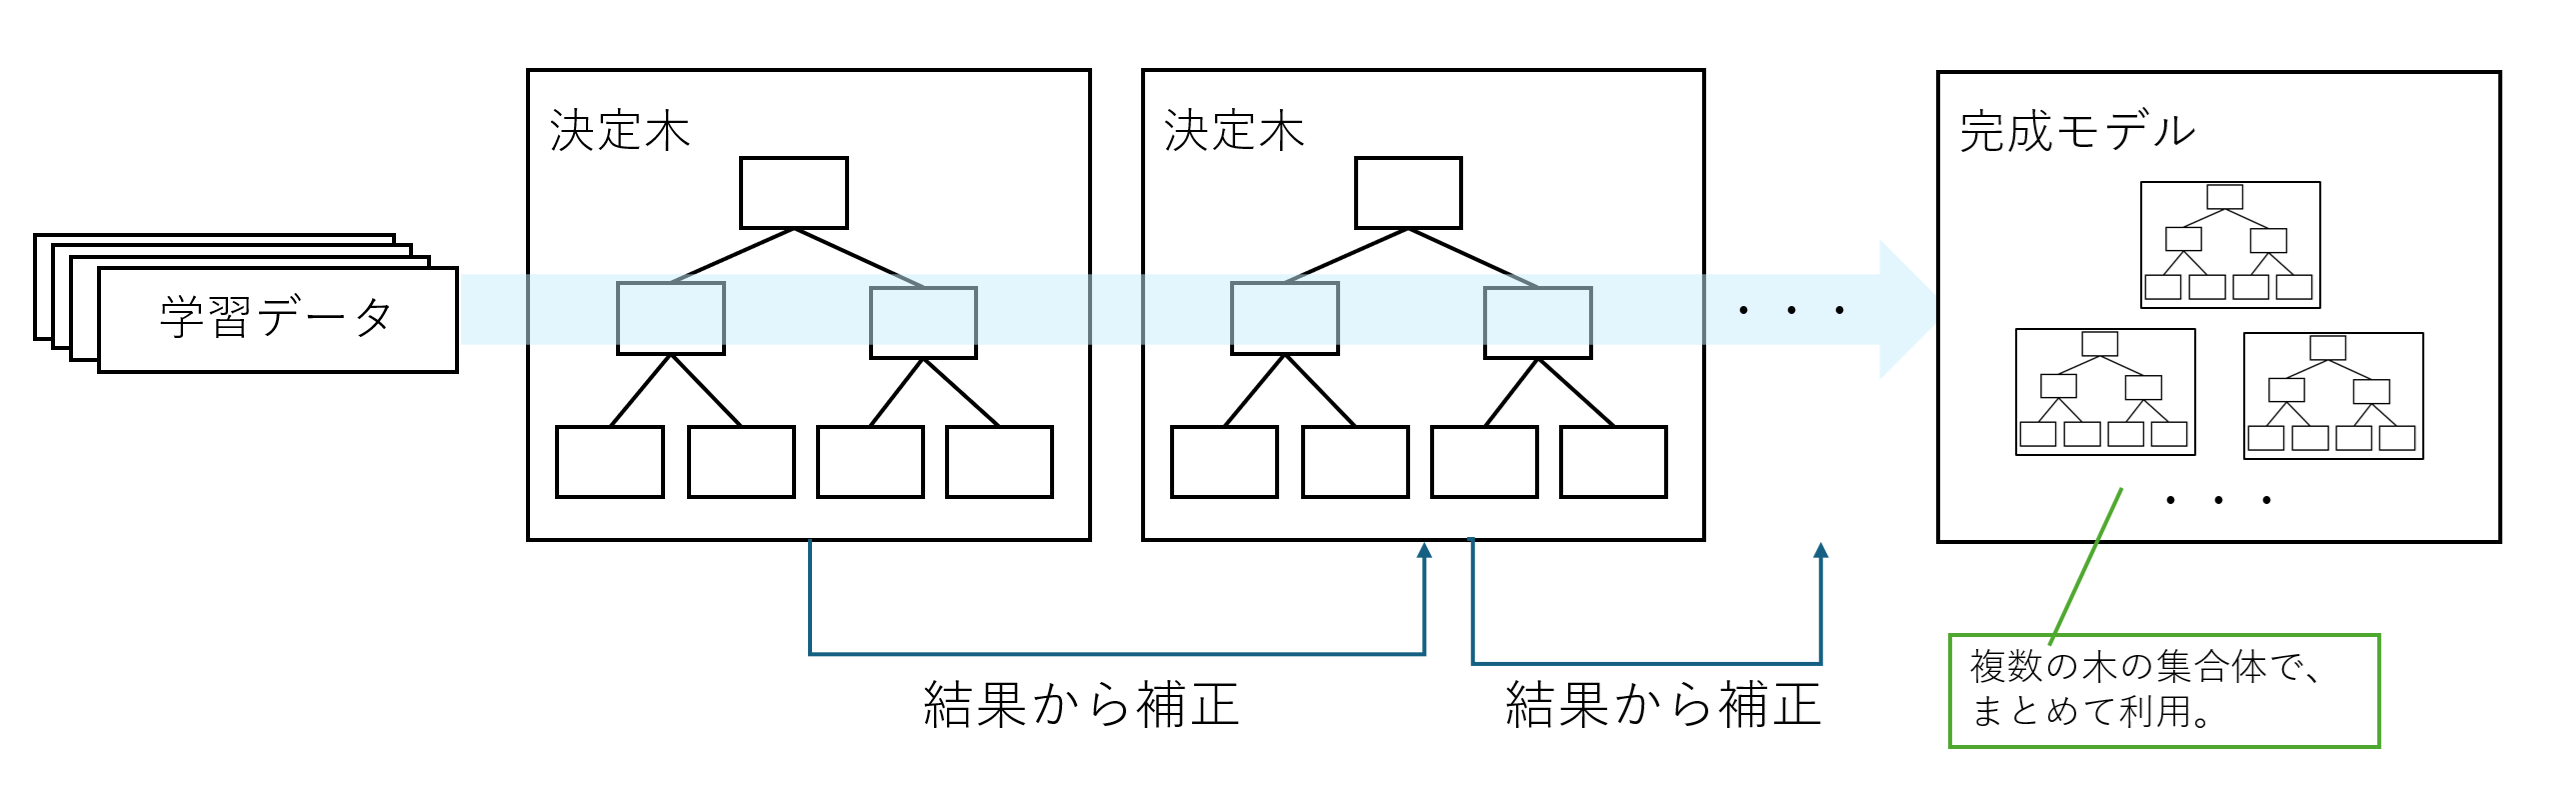
図2-4 XGBoostのイメージ概要
複数の学習器(=決定木)を順次的に準備/学習していく形式で、いわゆるアンサンブル学習と呼ばれる手法が使われています。
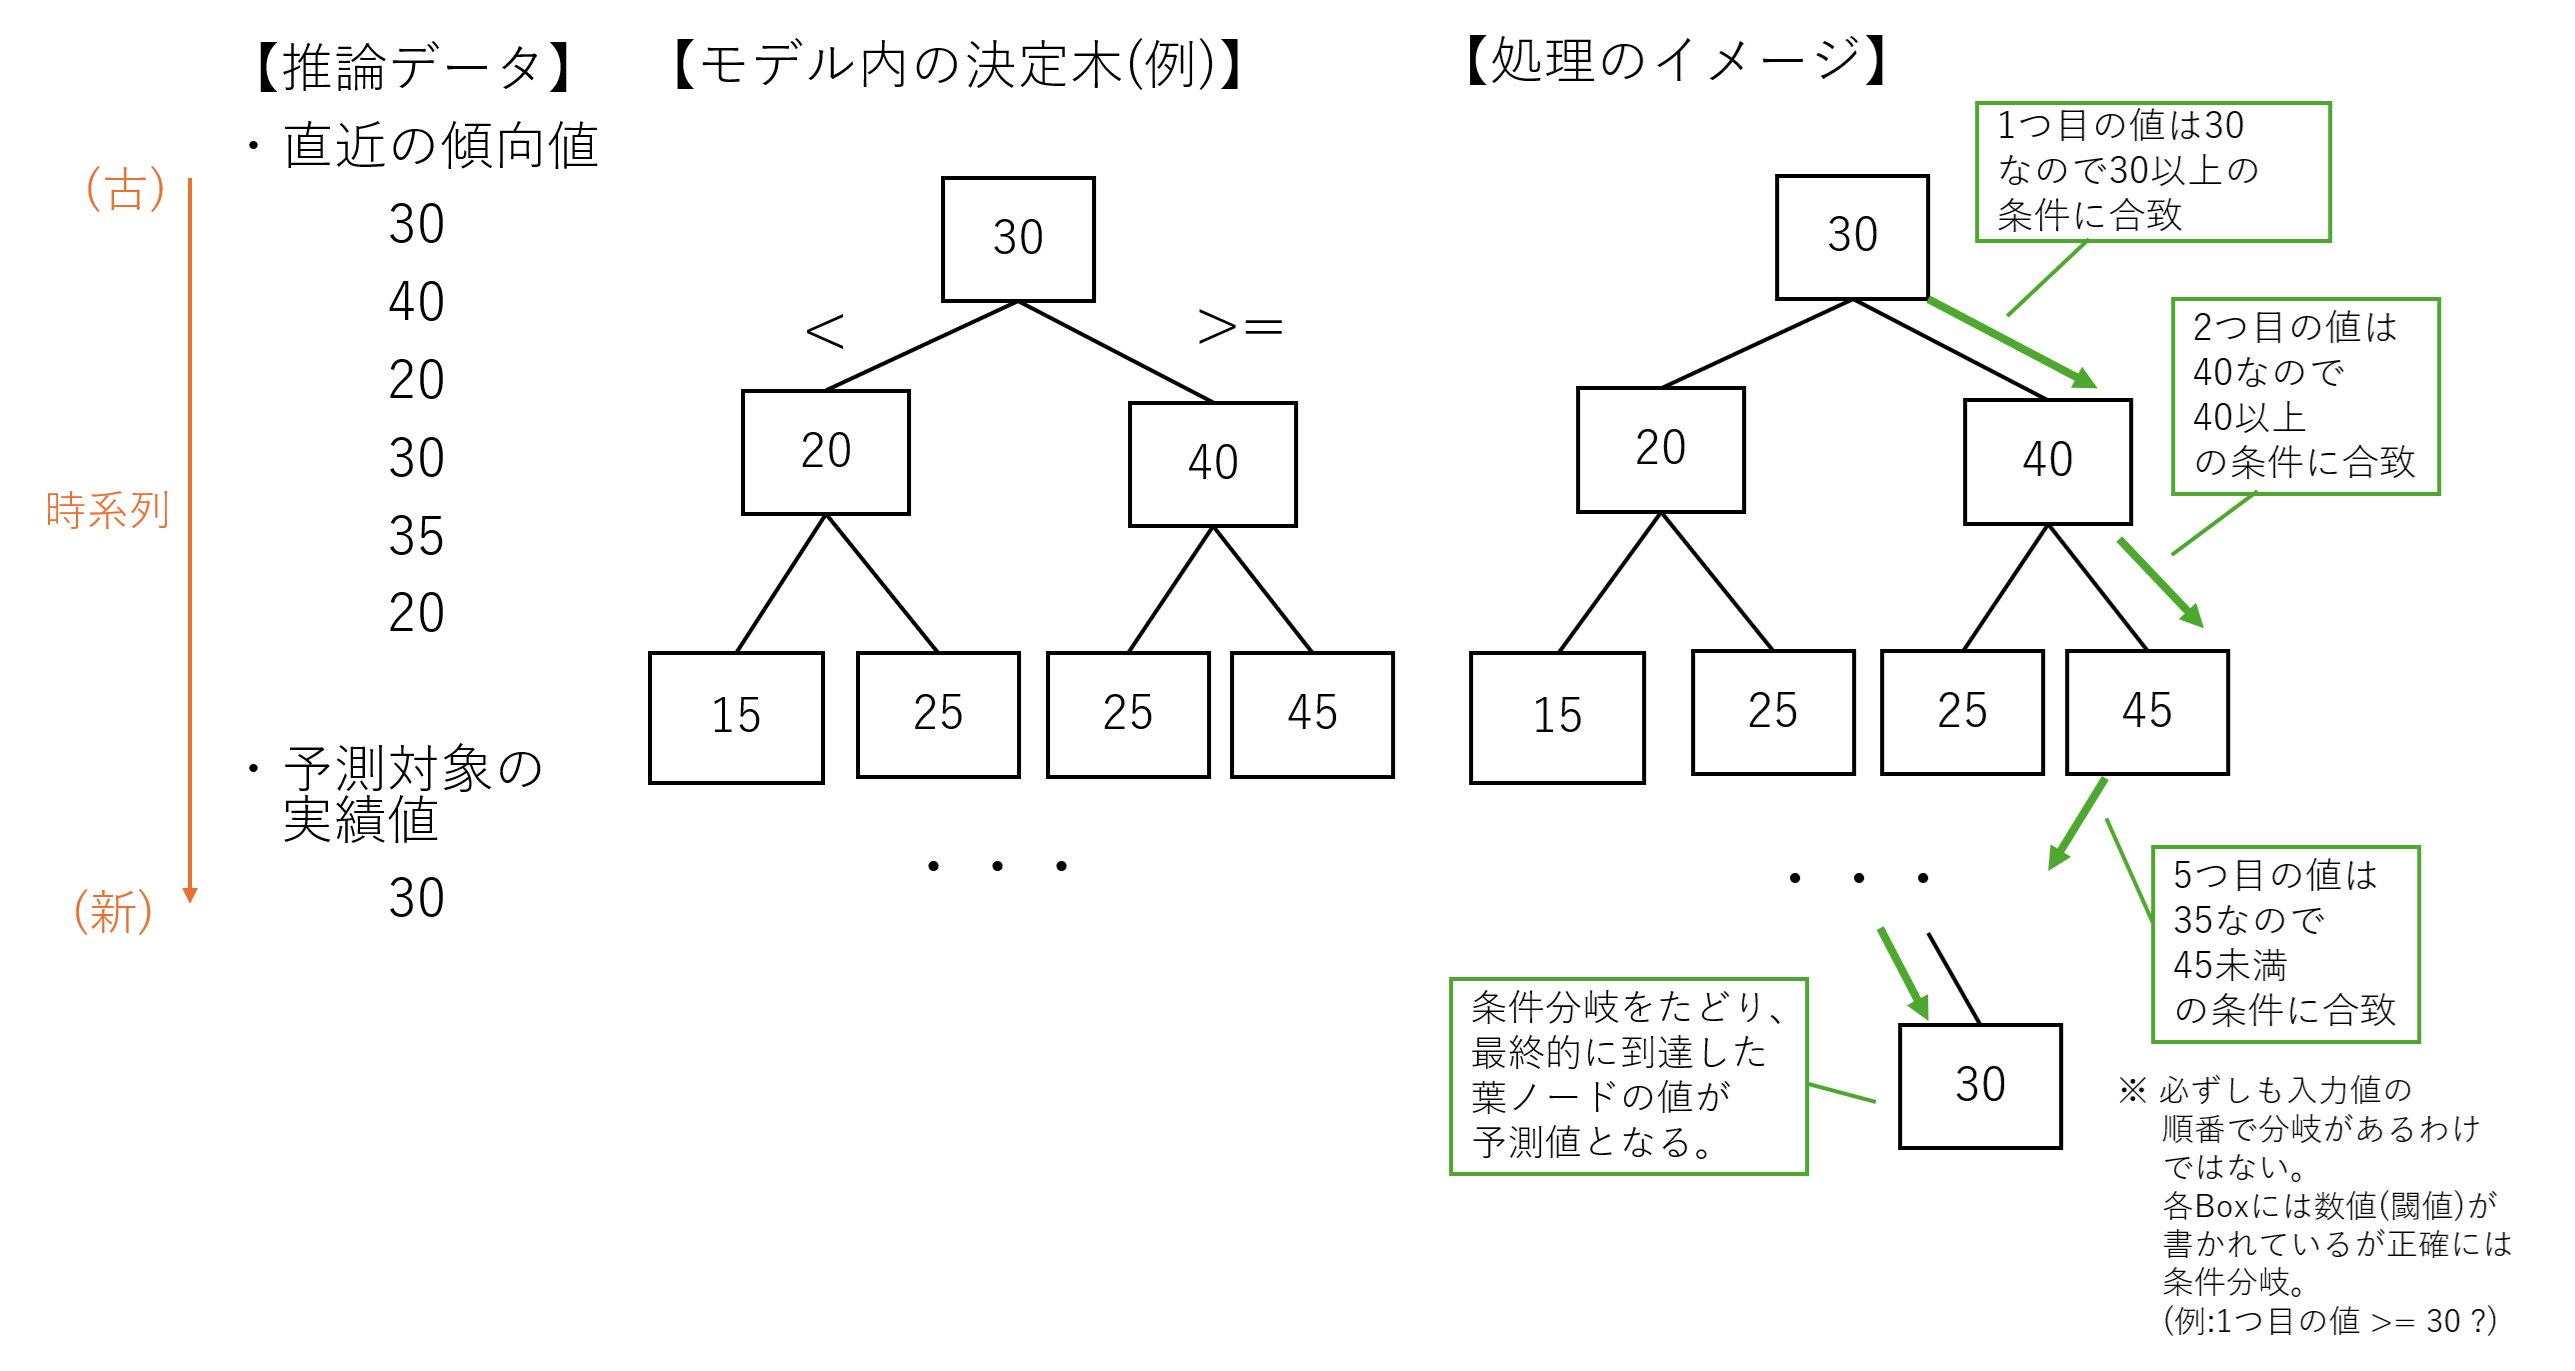
図2-5 XGBoostの推論イメージ概要
※ 本図は技術的な正しさというよりはわかりやすさを重視した記載としていますのでご承知おきください。
推論時は、学習した結果の判断基準と渡された値を比較して、特定の値を予測します。
| [補足2-2] 時系列データ予測に使われる手法と、ARIMA/SARIMAモデルについて 時系列データの予測にはXGBoostを利用することもできますが、他にも様々な方式があります。
この中でも時系列データ予測でよく知られている代表的なものが、「ARIMAモデル」や「SARIMAモデル」を活用する方法です。 ARIMAとは、「過去の値」「値の変化量」「過去の予測誤差」を意識しながら次の値を予測する手法です。 トラヒックにおいてはある種の規則性のような傾向もあるかと思います。 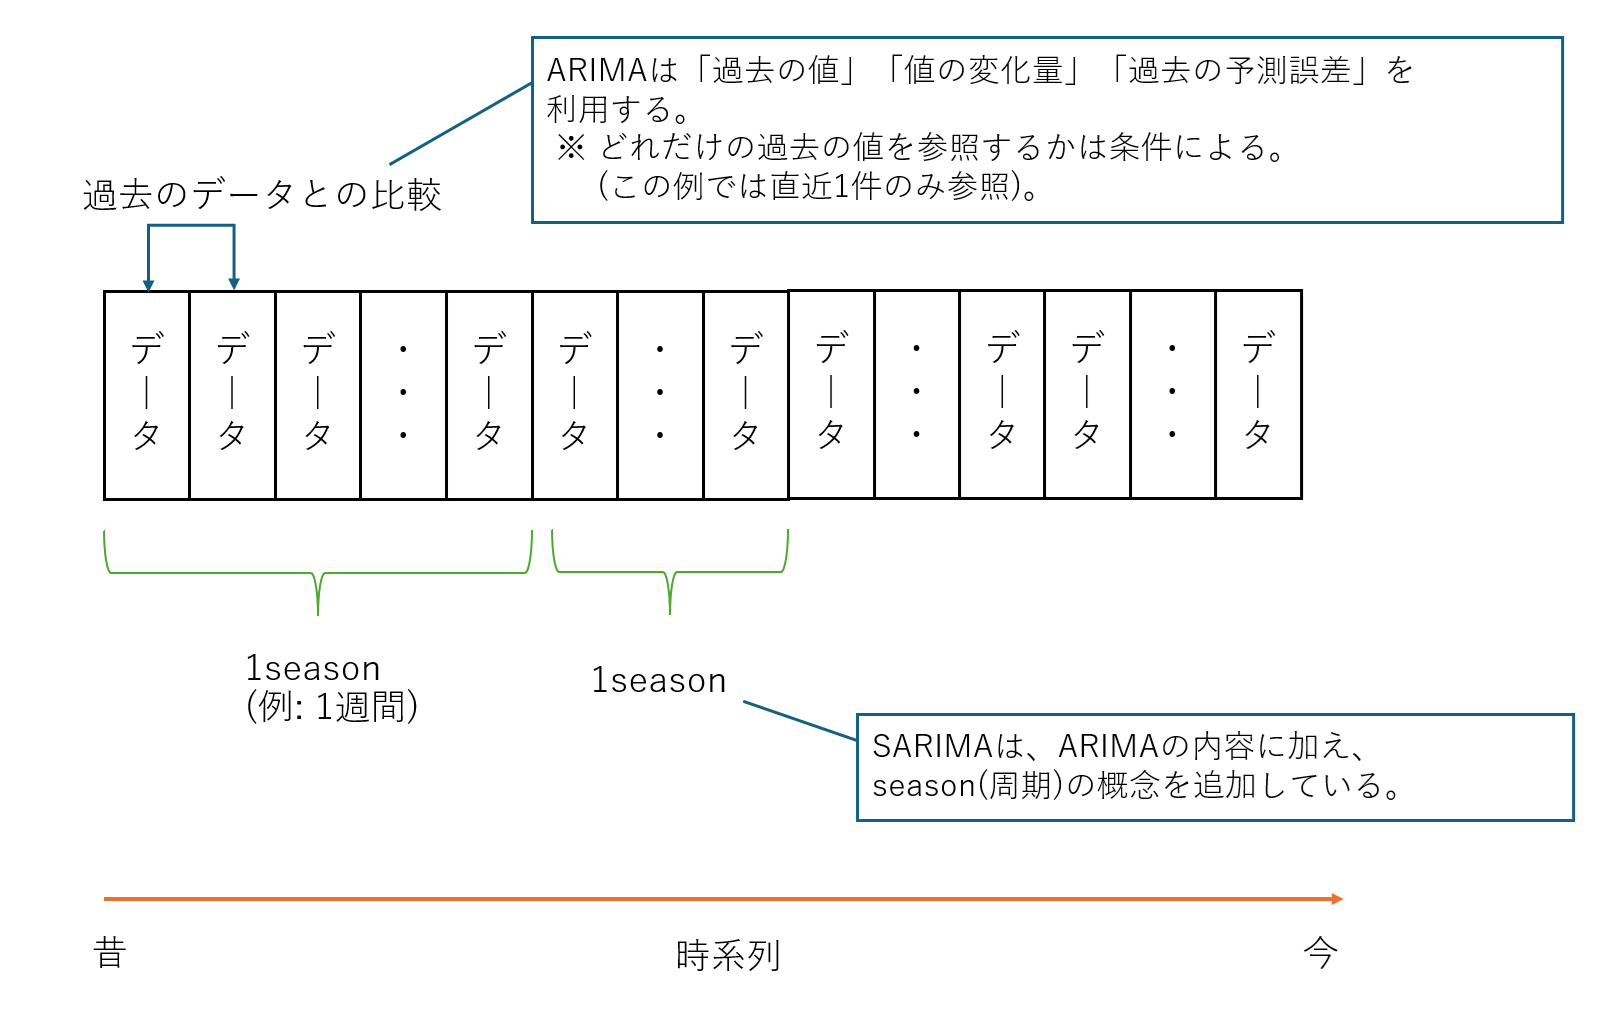
図2-6 ARIMA/SARIMAのイメージ トラヒックのように周期性があるものにはSARIMAは有力な選択肢となりえますが、基本的に最新の観測値を時系列順にモデルに渡していく(状態を更新していく)必要があります。 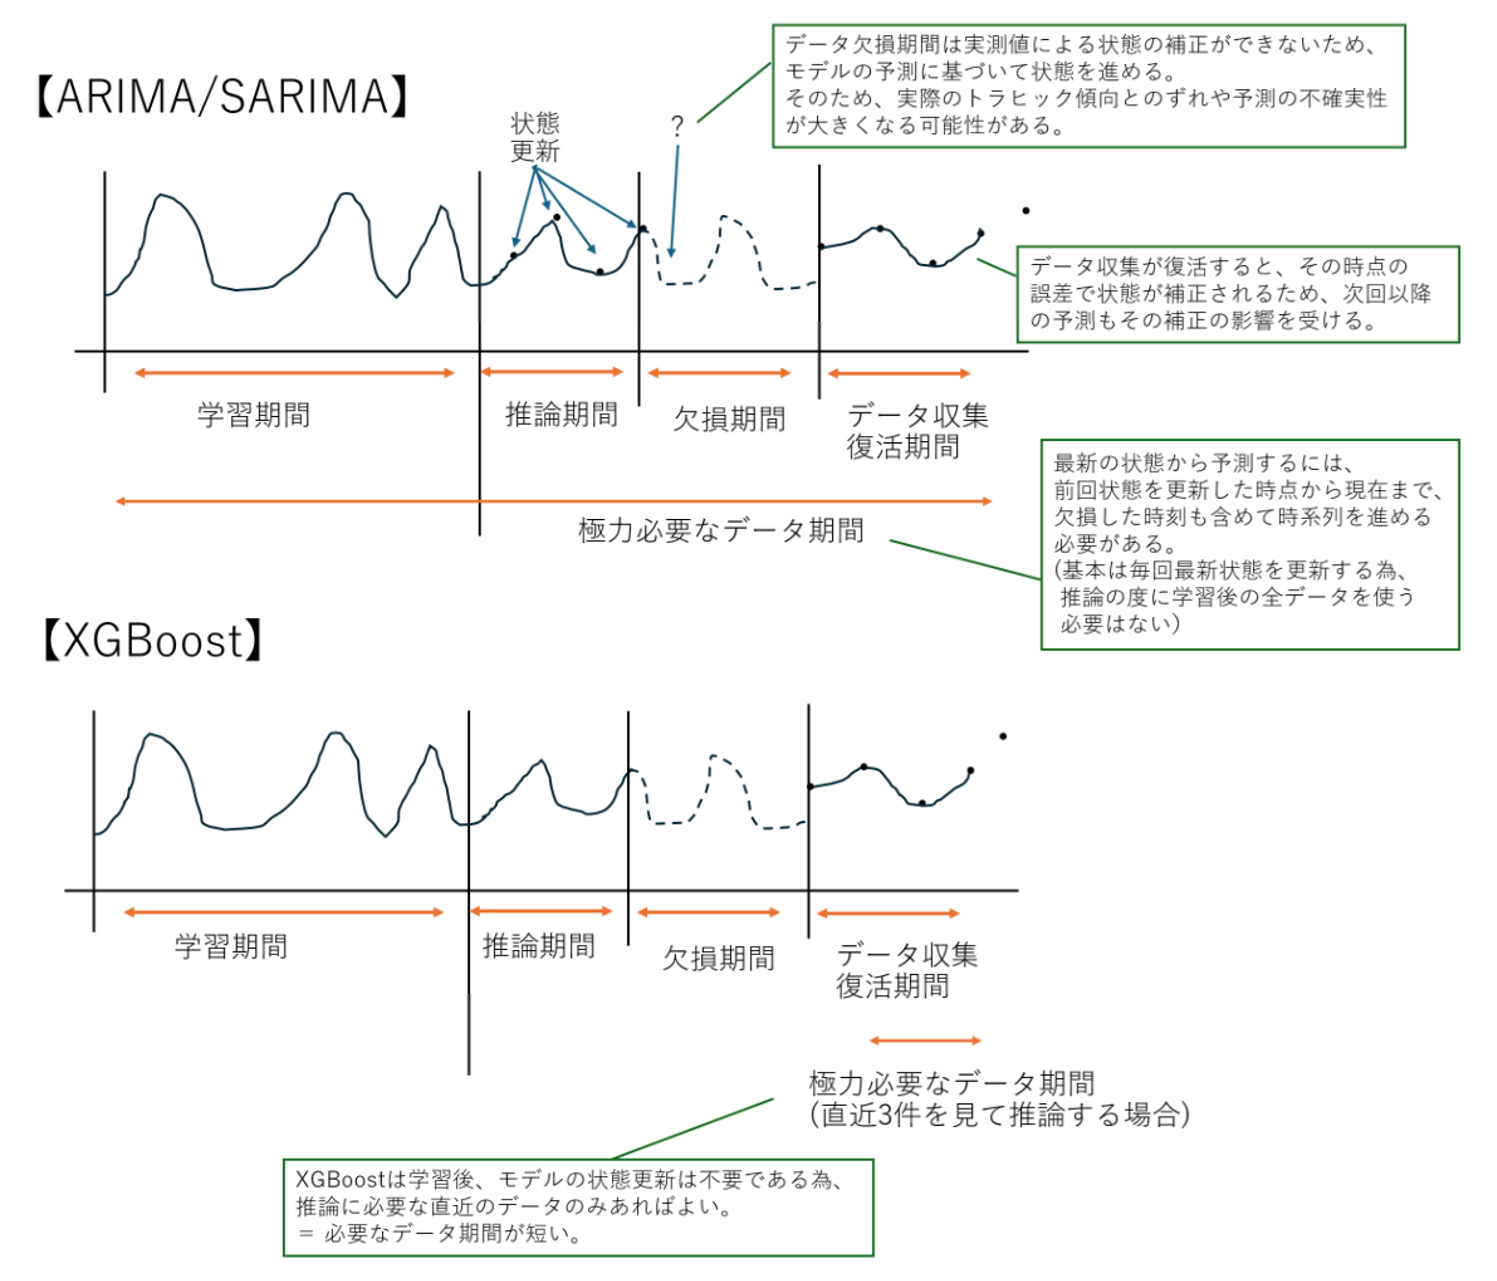
図2-7 ARIMA系とXGBoostの必要なデータ範囲イメージ 欠損値をどう扱うかは、AIの運用そのものにも関係します。 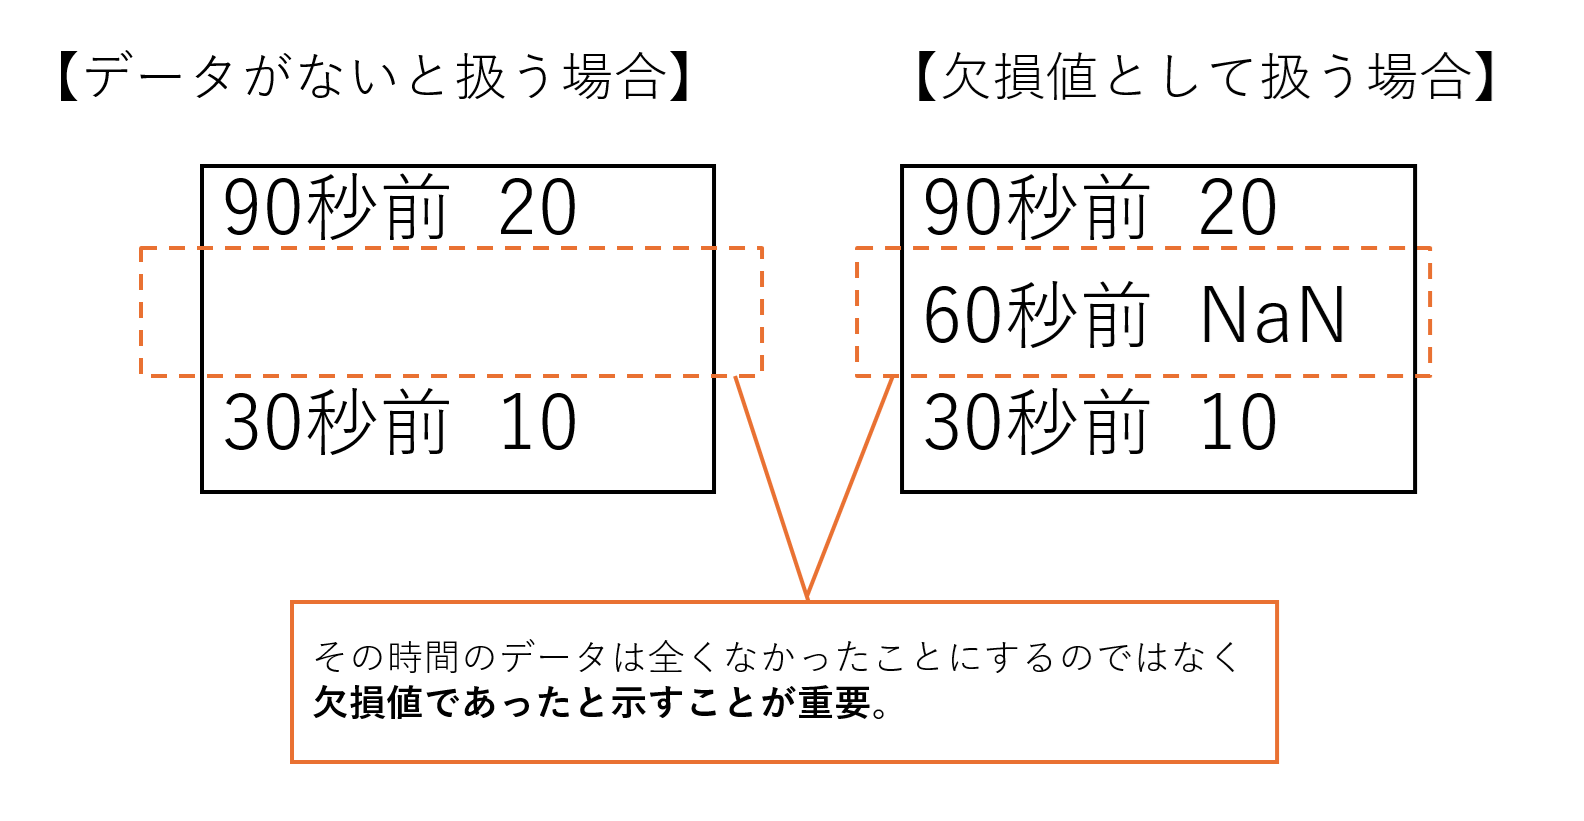
図2-8 欠損値の扱いについて |
|---|
その他にもどれぐらいのデータを学習範囲とするかであったり、予測誤差との差分の許容値をどう出すかの整理もありますが、これは後述(③ AIの学習用データの選定/抽出 にて紹介)します。
AI運用整理
AIを使う際には、その運用も考えていかないといけません。
今回の環境でのAI運用はシンプルな例とするため、事前に学習済のAIモデルを用意し、そのモデルを利用して定期的に推論/予測処理を実行する形とします。
| [補足2-3] モデルの管理と継続的な更新/デプロイ(CI/CD)について(MLOps) 前述の通り、今回は事前にモデルを作っておいてそれを利用する、かつモデルも1つしか使わないという極めてシンプルな運用例で記載しています。 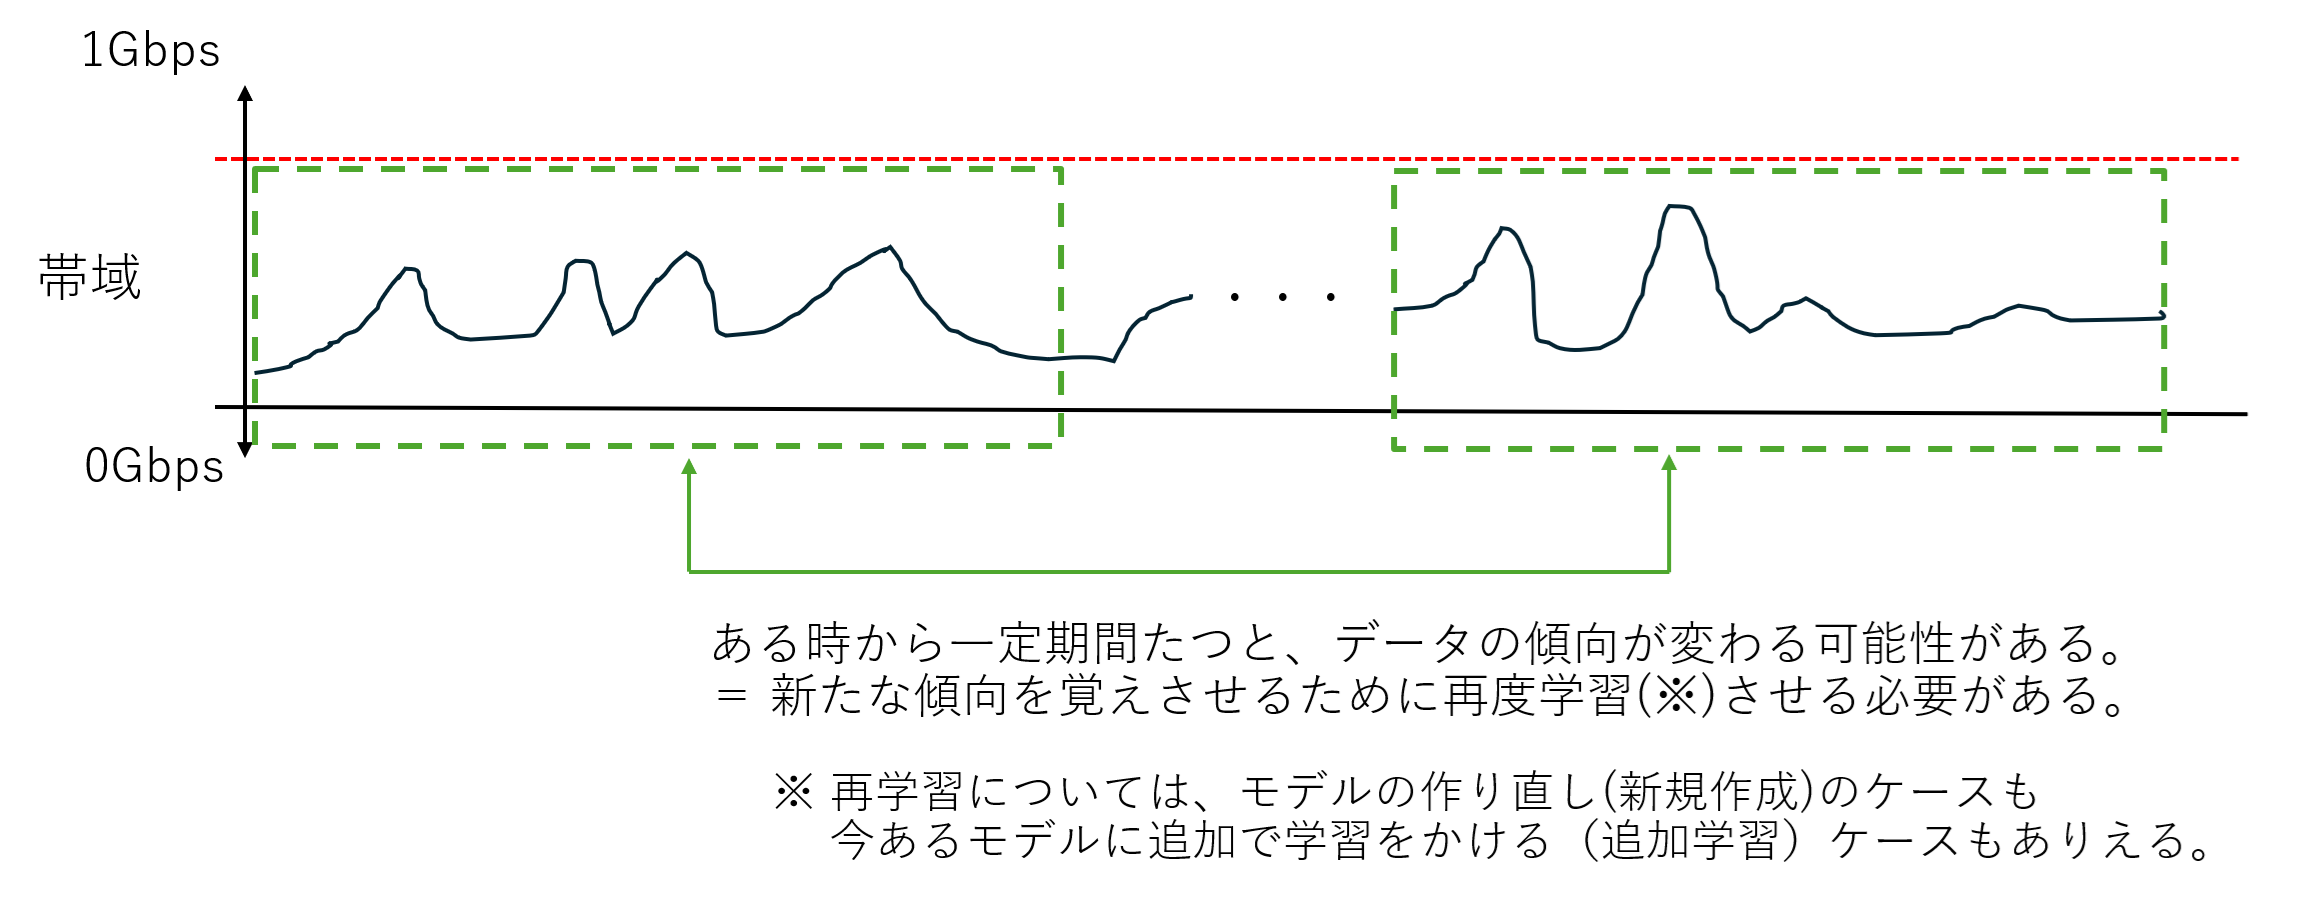
図2-9 時間の経過による傾向変化のイメージ 理由は、時間の経過とともにデータの傾向なども変わる可能性があるためです。 時間の経過でモデルが更新されていく場合、過去と現在でどのようなモデルや条件で利用されていたか管理していくことが重要となります。 また、モデルも今回は1モデルのみですが、複数のモデルを利用するケースもあるでしょう。 モデルの更新についても、単純に更新してデプロイすればよい、というわけでもありません。 したがって更新版のモデルを作ったとして、精度なども確認し、どういう条件だったらデプロイする、と整理することも重要です。 決められた手順で自動的にモデルの学習/評価/デプロイを行うCI/CDの概念がML利用においては重要となってきます。 また、デプロイした後の監視(可視化や通知含む)も重要です。 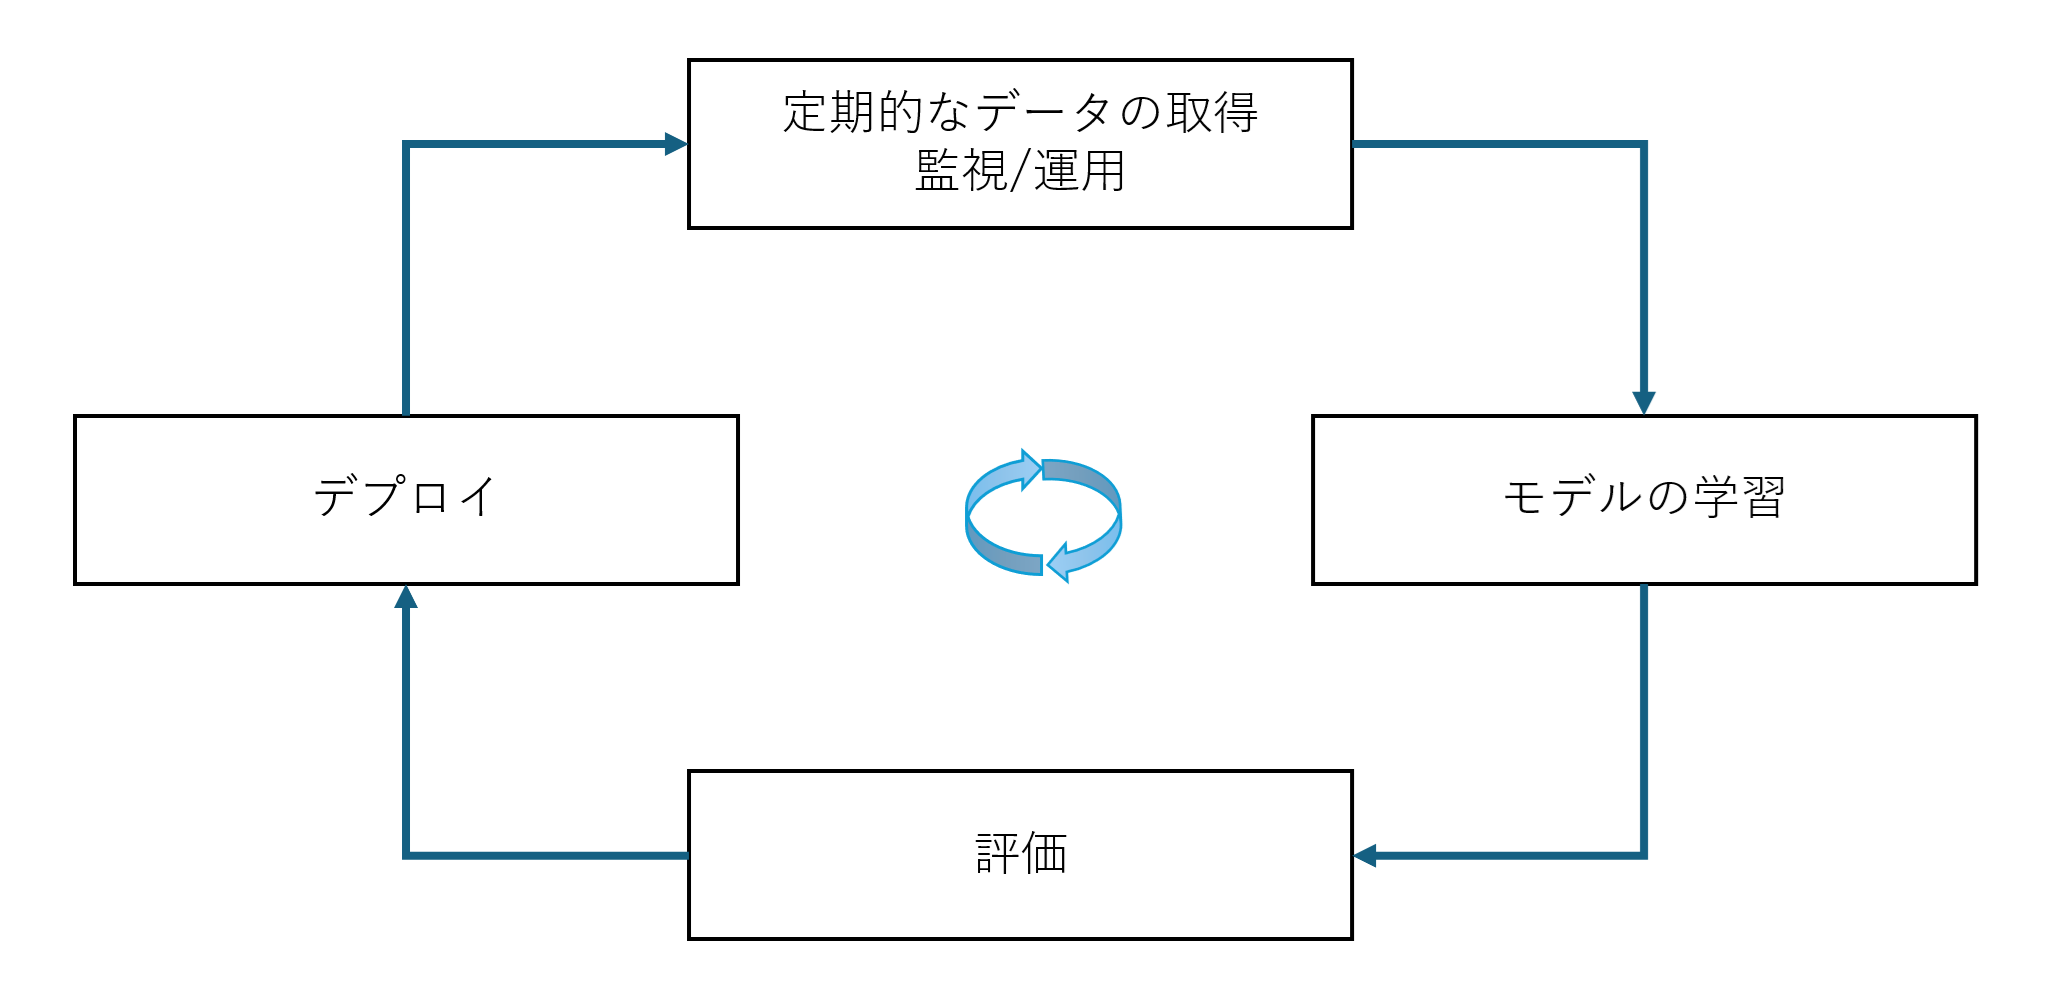
図2-10 MLOpsのイメージ このようにML環境では、モデルを作って配置すれば終わりではなく、その後の運用も含めて考える必要があります。 |
|---|
② データの収集
これは第1回で紹介した「監視/可視化基盤」にて実現している為、省略とします。
詳しくは第1回を参照ください。
③ AIの学習用データの選定/抽出
ここからは環境の準備とあわせて、学習用のデータの選定/抽出について説明します。
まずは、モデルを作るための下準備から進めていきます。
# 必要ディレクトリの用意と移動
$ mkdir /home/admin/xgboost
$ cd /home/admin/xgboost
$ mkdir ./model


# Python仮想環境の用意と実行
$ apt install python3.12-venv
$ python3 -m venv myenv
$ source myenv/bin/activate


# 必要なライブラリをインストール
(myenv) $ python -m pip install --upgrade pip
(myenv) $ vim requirements.txt
---
pandas
numpy
xgboost
requests
paramiko
---


(myenv) $ pip install -r requirements.txt
今回は上の手順の通り、Python仮想環境(venv)を利用します。
監視/可視化基盤側はk3sでコンテナ化しているため、本来は学習や推論処理もコンテナ化し、k3s管理下に置く(マイクロサービス化する)のが理想ですが、今回は手順簡略化の為、省略とし、コンテナではなくVM内でPythonツールを実行する形とします。
下準備ができたら、AIの学習用データの選定/抽出を行います。
必要なデータはPrometheusから取得します。
(myenv) $ curl -G "http://localhost:30090/api/v1/query_range" \
          --data-urlencode 'query=rate(sonic_counters_ethernet4_SAI_PORT_STAT_IF_IN_OCTETS[30s]) * 8' \
          --data-urlencode 'start={開始時間情報}' \
          --data-urlencode 'end={終了時間情報}' \
          --data-urlencode 'step=30s' > traindata.json
今回はSONiCの入力IF(=eth2/Ethernet4)の傾向から判定をしたいため、当該IFのトラヒック量を30秒ごとの値で取得し、それを「traindata.json」としてファイル化しています。
Telemetryとしては10秒ごとにデータ収集しており、その頻度/間隔での学習もできますが、今回はもう少しならした形で傾向を捉えられると良い為、30秒ごとの値としています。(Grafanaによる可視化と同様に30秒ごとの平均bpsとしています)
| [補足2-4] データの頻度について データの頻度は細かければ細かいほど、短期的な変化(例えばスパイク的な値の変化)をとらえやすいモデルとなりますが、一方で全体的な傾向が見えづらくなります。 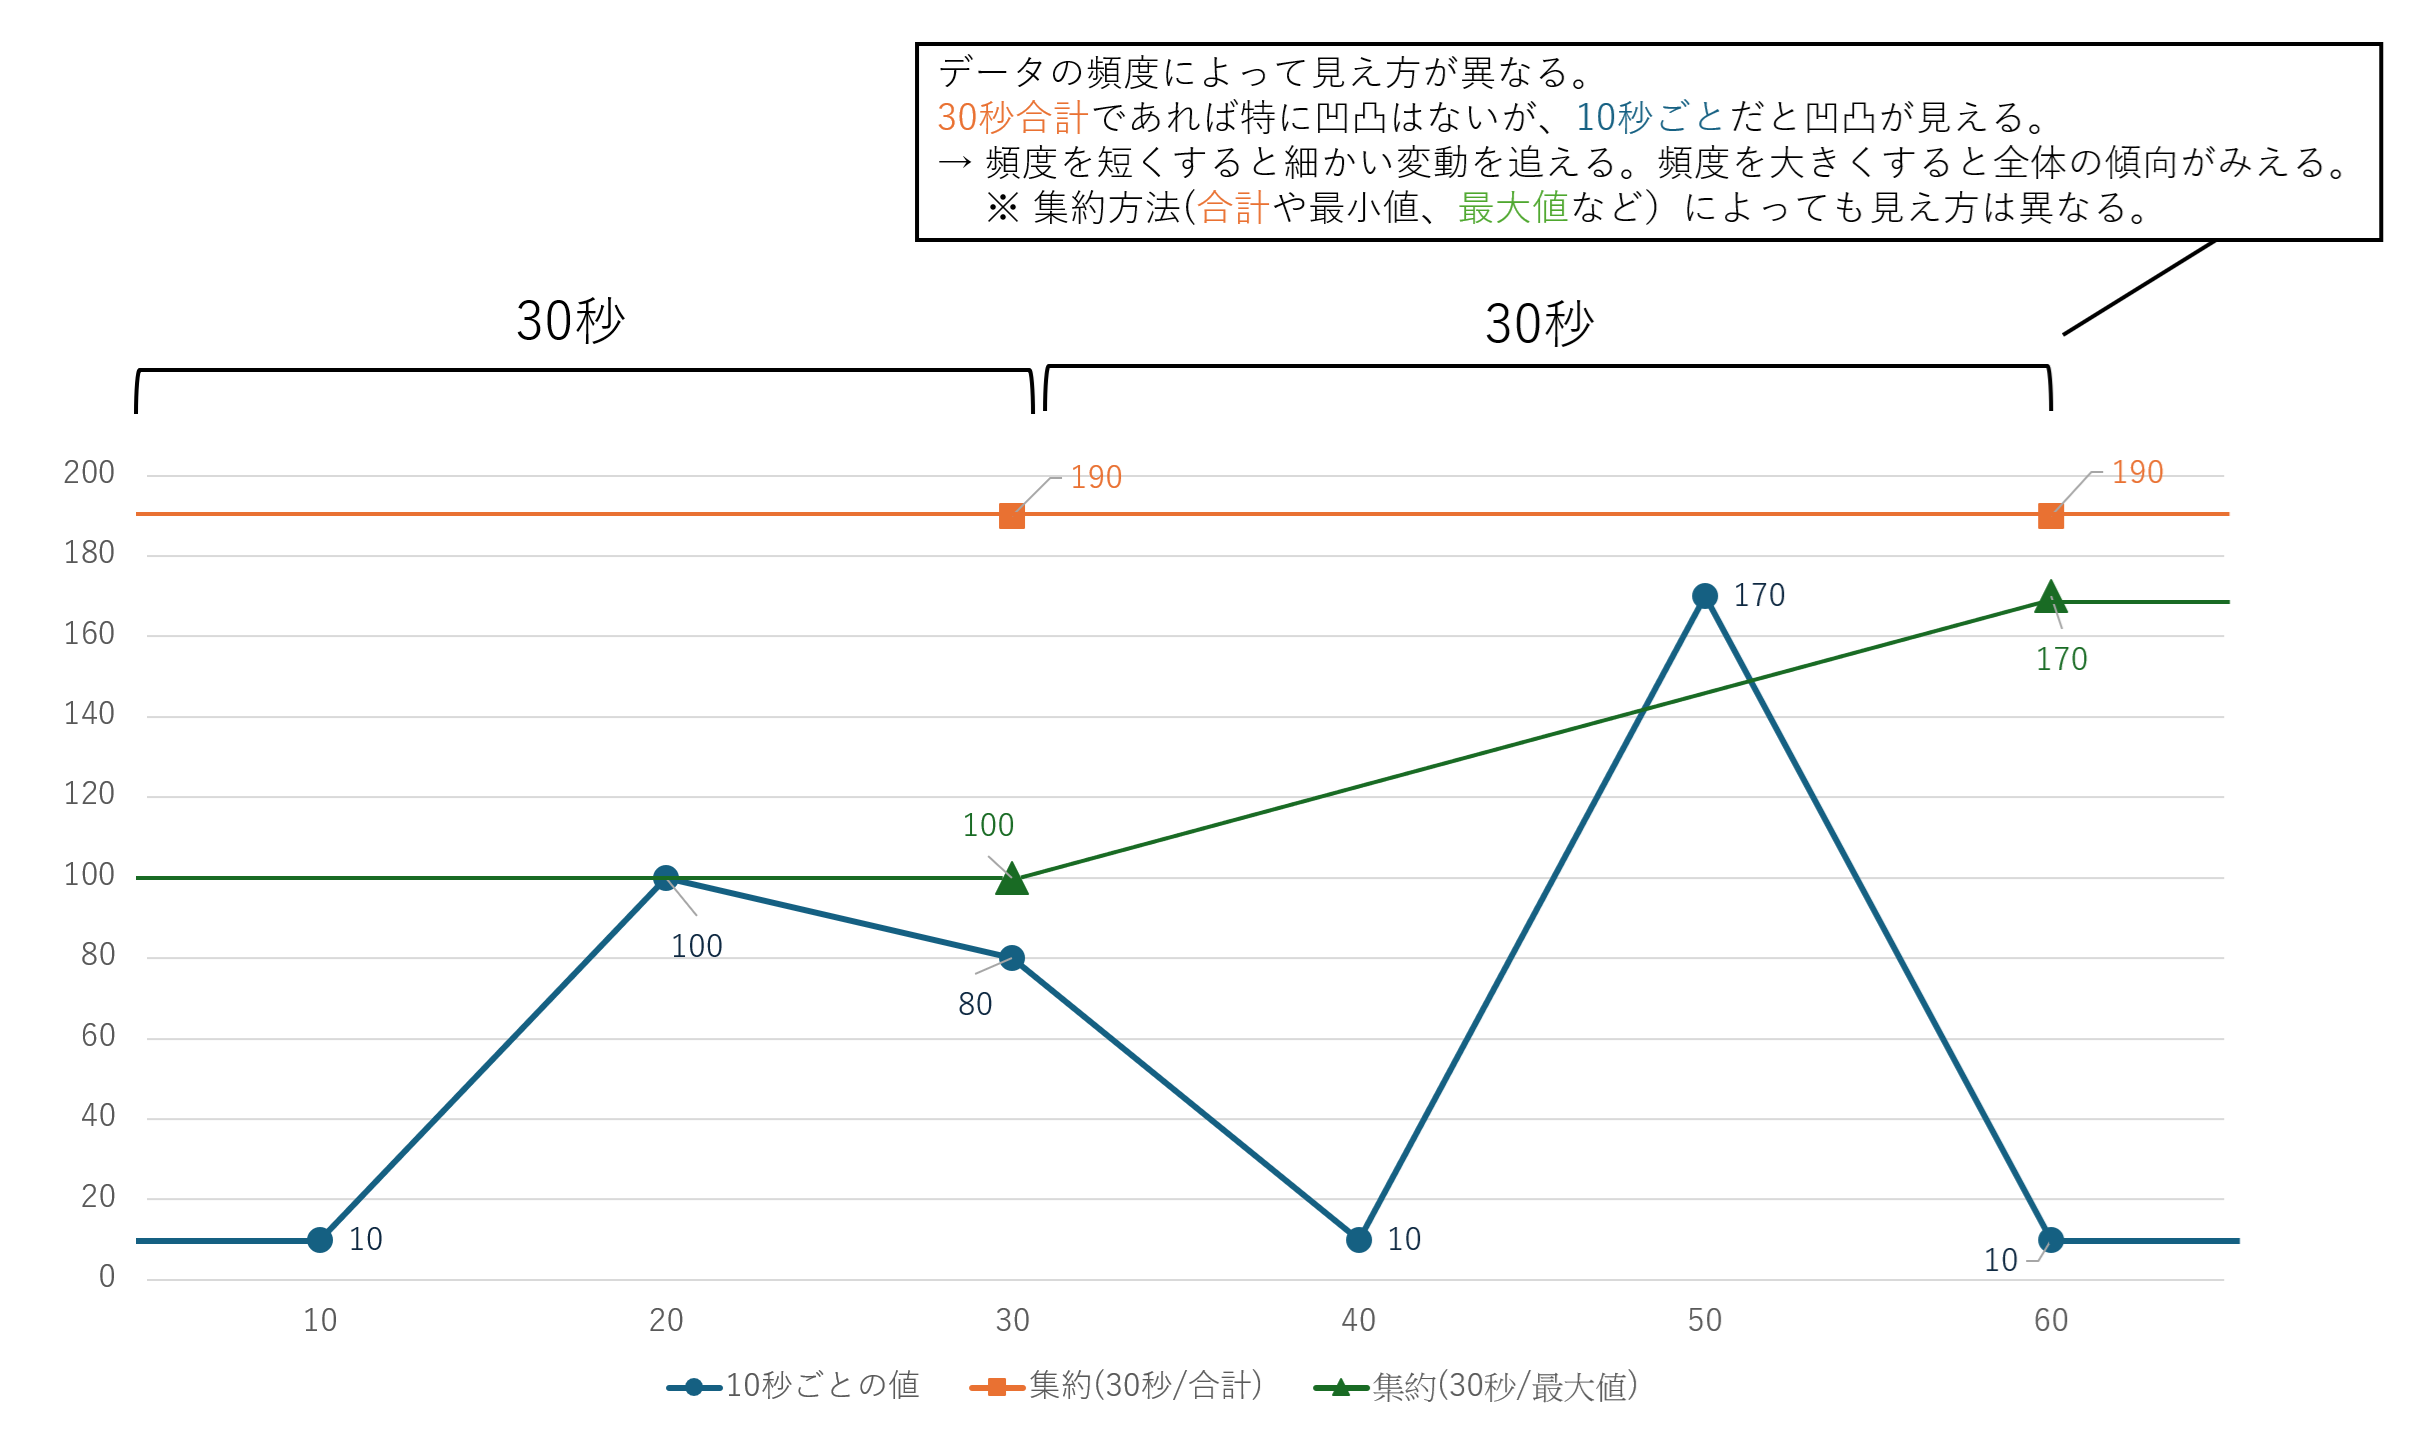
図2-11 データの頻度(粒度)と集約方法によるデータの見え方の違い例 このようにデータ頻度(間隔)によって、同じデータでも見え方や傾向は異なります。 なお、学習と推論は取得データの頻度(単位)を合わせる必要があります。 |
|---|
学習データ数については、前述のcurlコマンドの開始~終了時間の範囲となりますが、今回は6時間分(21600秒÷30秒= 720件)を学習データとして扱います。
開始/終了時間情報は「2026-07-01T00:00:00Z」のような形式で指定します。
試験トラヒック用サーバの準備でiperfをかけた状態にしており、監視/可視化基盤の準備もできていれば(手順通り進めていれば)通常時のトラヒック情報が着々と集まっているかと思います。
もし十分にデータがそろっていない場合は、少し待ってデータを集めてからデータ取得の上、次の段階に進みましょう。
サンプルとしてcurlで取得した情報の形式を例として以下に表示します。(3件のみ表示)
{
  "status": "success",
  "data": {
    "resultType": "matrix",
    "result": [
      {
        "metric": {
          "host": "Monitor",
          "instance": "telegraf-sonic-metrics.telemetry.svc.cluster.local:9273",
          "job": "telegraf-sonic",
          "path": "/COUNTERS/Ethernet4",
          "source": "127.0.0.1"
        },
        "values": [
          [
            1782864000,
            "980000.0"
          ],
          [
            1782864030,
            "1020000.0"
          ],
          [
            1782864060,
            "990000.0"
          ]
        ]
      }
    ]
  }
}
今回は時系列のデータ判定を行う為、直近何件のデータを見て、次の値を予測するか、も整理しなければなりません。
今回は6件(30秒×6 = 3分)の値/傾向を見て次を予測する形にしたいと思います。
時系列データにおいてはこのような過去のデータ、つまり現在から時間的に遅れたデータをラグ(LAG)といい、過去のデータ傾向を見て得られた特徴をラグ特徴量といったりします。
LAGというとリングアグリゲーションのほうがNW領域では有名かと思いますが、本記事では時系列データとしての意味合いでLAGという言葉を使います。
ポイントとしては、推論する際には7件のデータが必要となる点です。
直近の傾向を見るためのデータ6件(3分)と、現在のデータ1件(AIの予測値と実績の比較に利用する実績値)です。
データ6件だけで推論が動くわけではないので注意しましょう。
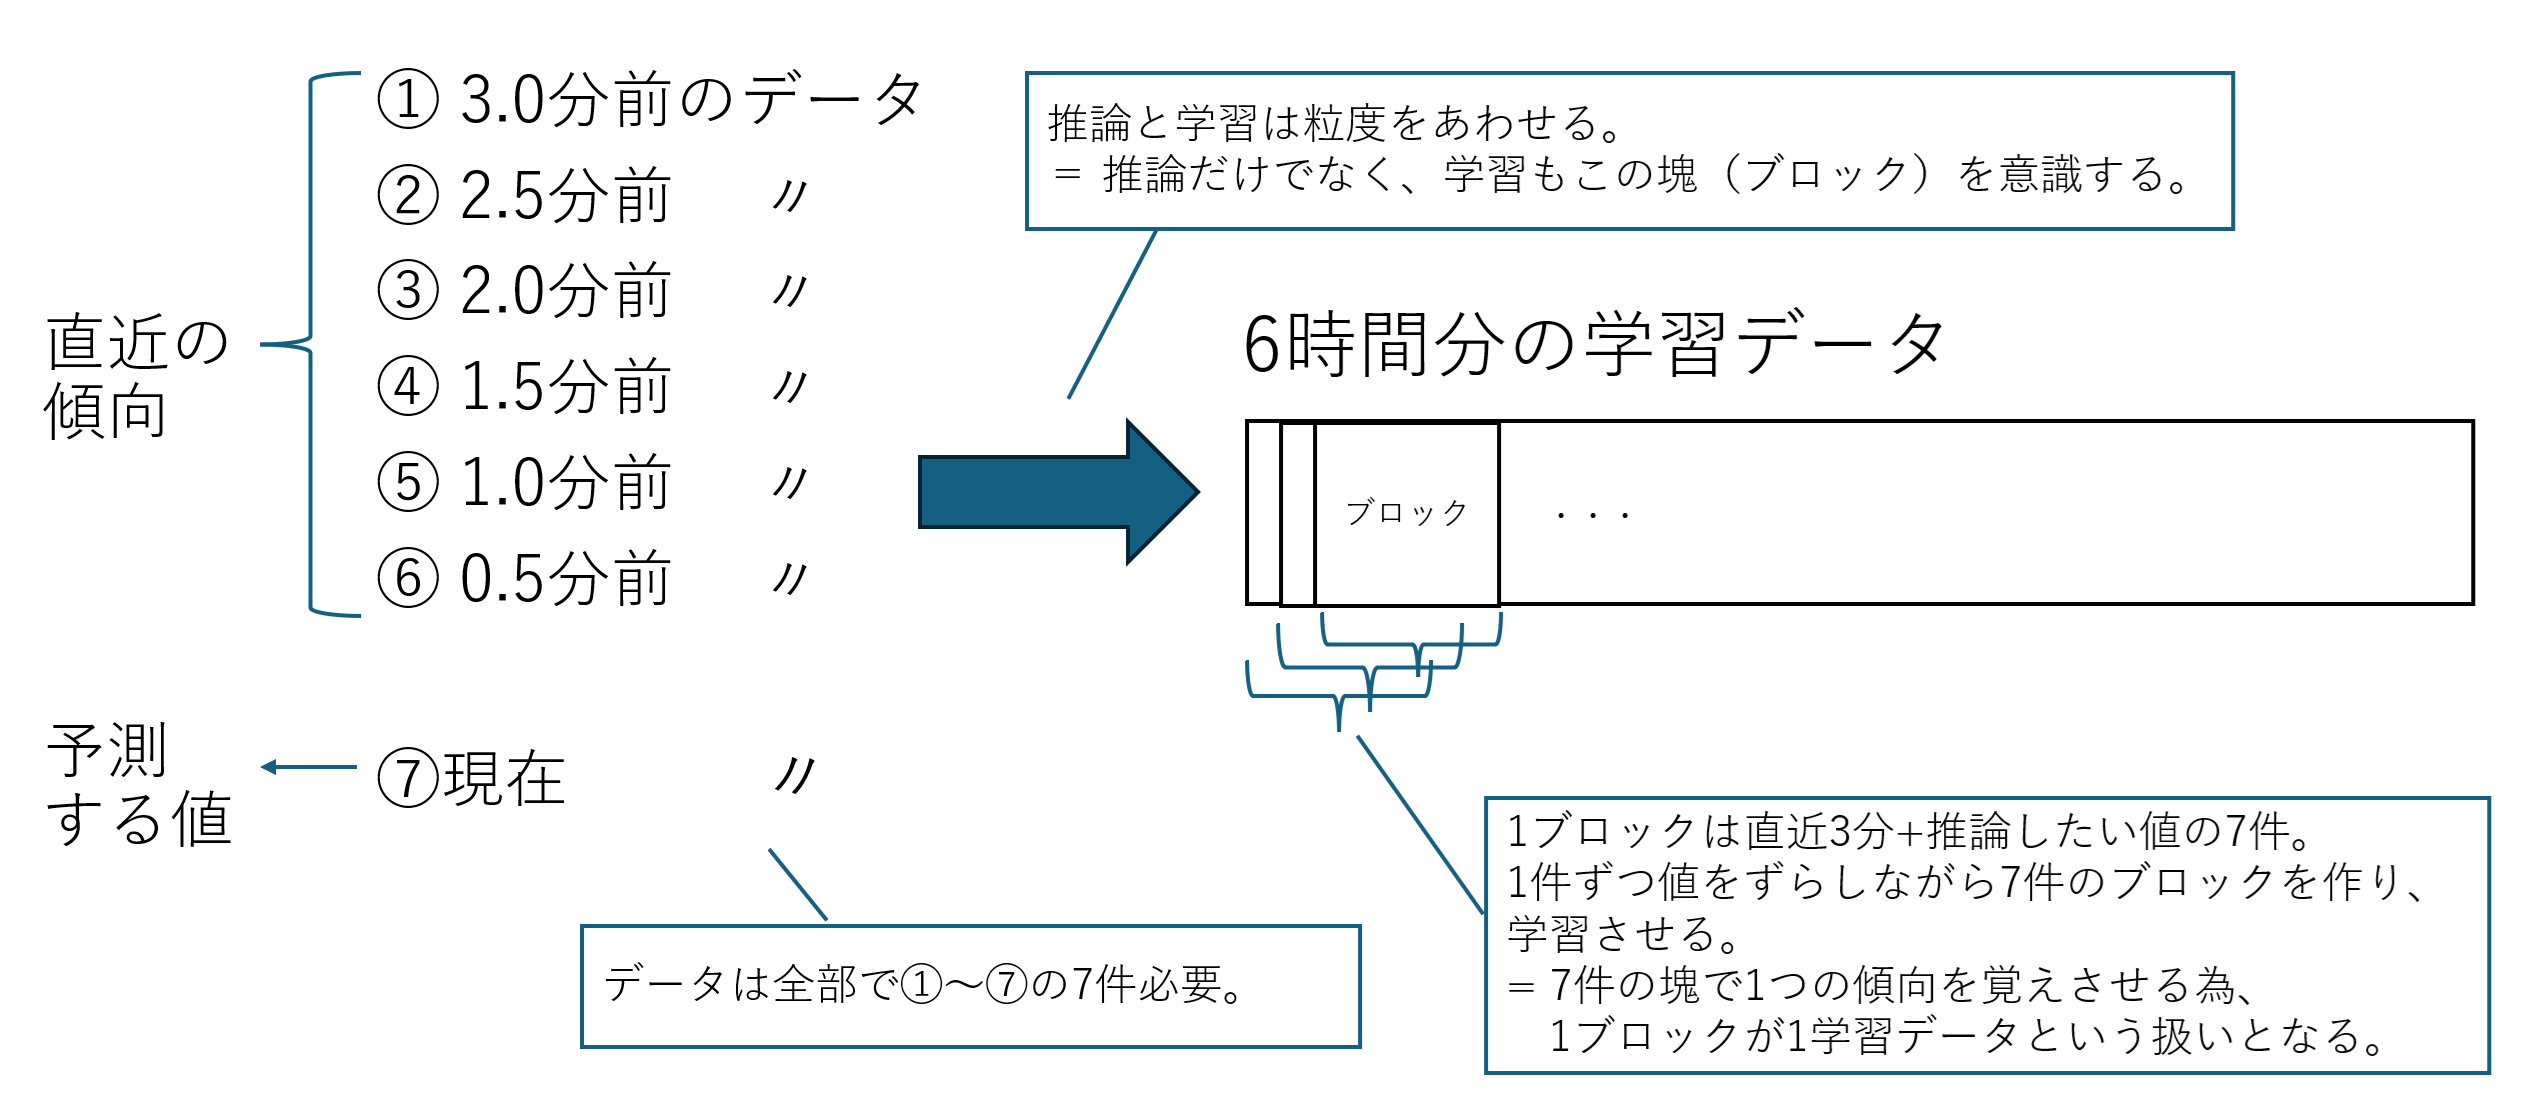
図2-12 利用するデータの扱いについて
もう1点整理しないといけないのは「予測誤差がどれだけ出たら異常とするか」です。
よく使われるのが99パーセンタイルや95パーセンタイルといった考え方です。
これは学習時の予測誤差の99%,あるいは95%以下を正常とし、それを超えると異常とする考え方です。
例えば99パーセンタイルは、学習用のデータが100件あったとき、予測誤差が小さい順に並べて99個目の値を基準とするイメージです。
予測誤差を小さい順に並べた時、「1, 2, 3」という形で1ずつ上がっていくものがあった場合、99個目は予測誤差99となります。
つまりほとんどは予測誤差99以下という傾向となったといえます。
推論時、この予測誤差(99)を超えた場合に異常と判定します。
この例からも99パーセンタイルより、95パーセンタイルのほうが厳しめの条件といえるとわかるかと思います。
甘めにすると小さな異常が見逃しやすくなる一方、厳しめとすると誤検知が増えやすくなります。
今回は大きな異常を検知することを目的とし、99パーセンタイルを採用します。
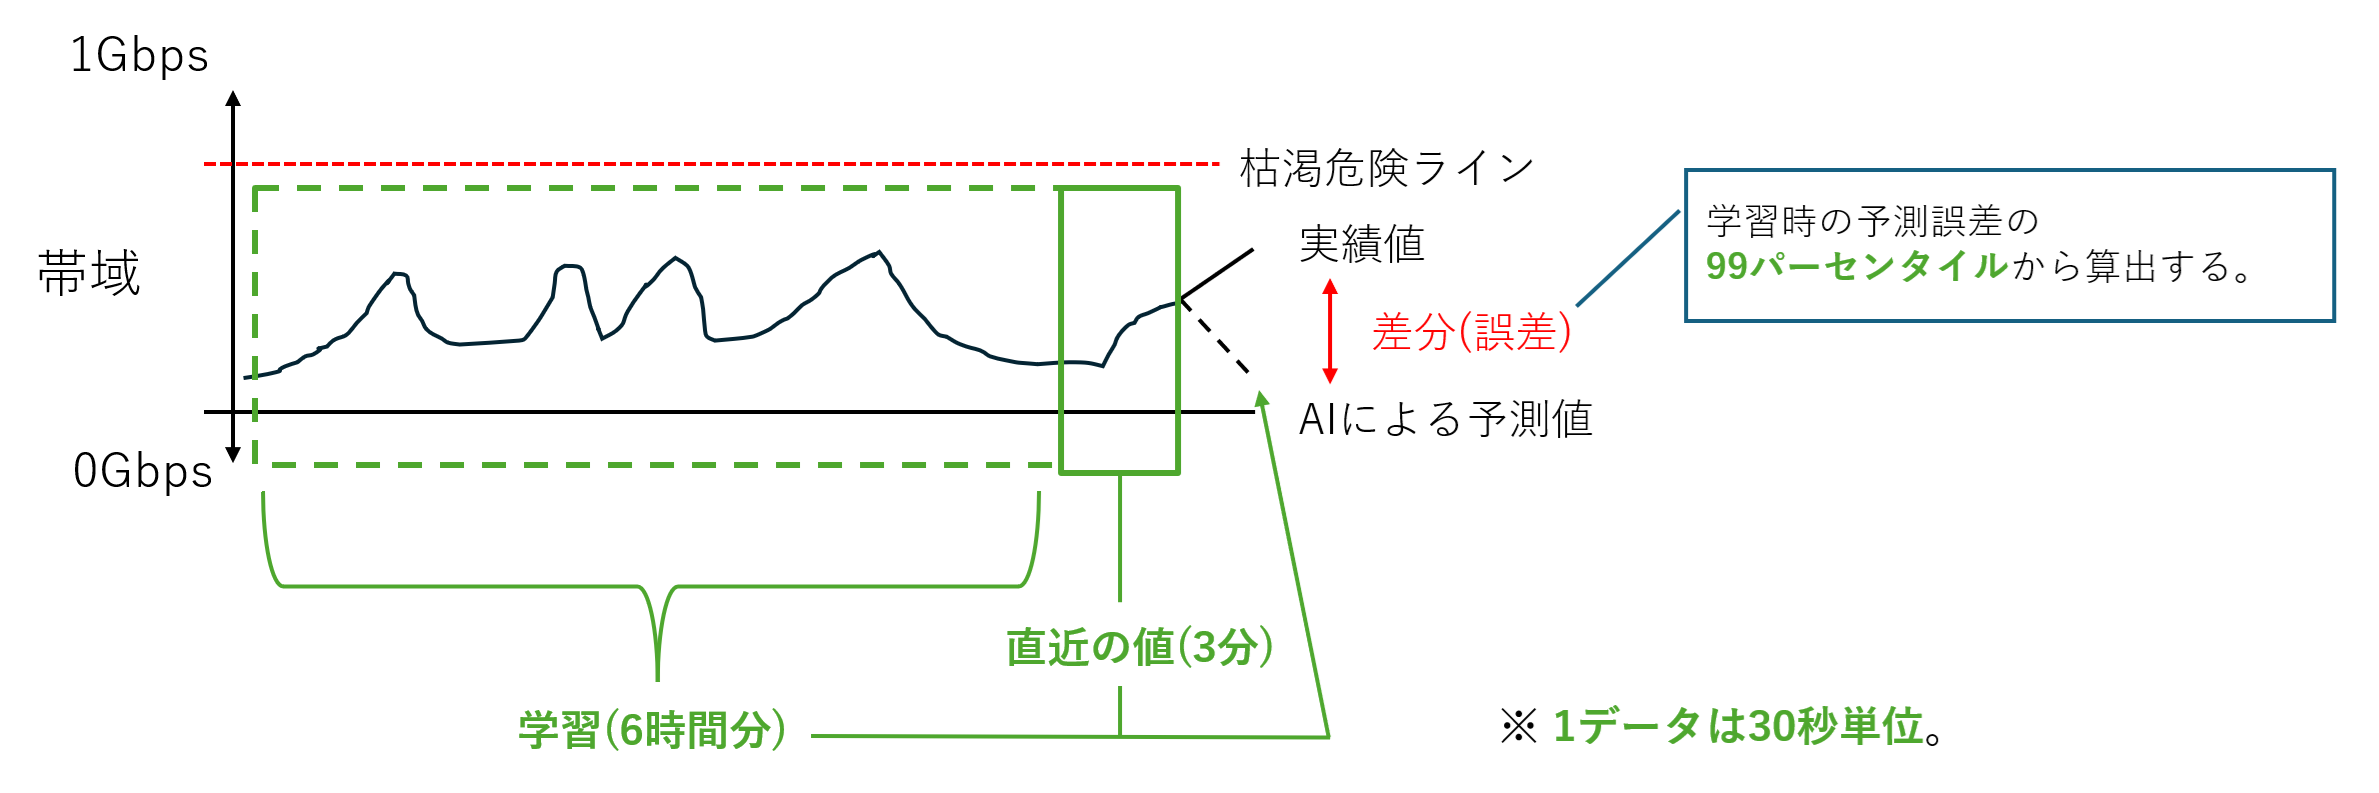
図2-13 今回の条件まとめ
これで学習に関する条件整理と準備は完了です。
また、「① AI利用に関する設計」「② データの収集」「③ AIの学習用データの選定/抽出」と順を追って進めてきた「AI利用に関する設計と事前準備」も完了となります。
3. 学習ツール
④ データの加工(前処理) ~ ⑥ 精度確認(モデルの評価)
以下の工程は、Pythonツール(学習ツール)にて実現します。
④ データの加工(前処理)
⑤ 学習によるモデル作成
⑥ 精度確認(モデルの評価)
本項では、まずは「コードと処理の概要」目にて処理の概要をおさえ、次に特におさえておきたい箇所を「ポイント」目にて説明、最後に動作させた結果を「実行例」目にて紹介します。
コードと処理の概要/学習ツール
以下に学習用のコードを示します。(ポイントは後述します)
(myenv) $ vim train_xgboost.py
import json
from datetime import datetime, timezone
from pathlib import Path


import numpy as np
import pandas as pd
from xgboost import XGBRegressor


TRAIN_DATA_PATH = "traindata.json"


MODEL_DIR = Path("/home/admin/xgboost/model")
MODEL_PATH = MODEL_DIR / "xgboost_model.json"
MODEL_META_PATH = MODEL_DIR / "xgboost_model_meta.json"


# データ頻度
FREQ = "30s"


# 30秒 × 6点 = 3分
LAG_COUNT = 6


# 先頭80%を学習、後半20%を検証
VALIDATION_RATIO = 0.2


# 検証誤差の99%が収まる値を異常判定閾値にする
ANOMALY_PERCENTILE = 99


def load_prometheus_range_json(path: str) -> pd.Series:
    """
    Prometheusから取得したtraindata.jsonを読み取り、
    データをPythonツールが利用できるようにデータフレーム化する。
    """
    with open(path, "r", encoding="utf-8") as f:
        raw = json.load(f)


    results = raw["data"]["result"]


    if not results:
        raise ValueError("JSON内に data.result がありません")


    values = results[0]["values"]


    df = pd.DataFrame(
        values,
        columns=["timestamp", "bps"],
    )


    df["timestamp"] = pd.to_datetime(
        df["timestamp"],
        unit="s",
        utc=True,
    )


    df["bps"] = pd.to_numeric(df["bps"])


    series = (
        df.set_index("timestamp")
        .sort_index()["bps"]
        .asfreq(FREQ)
    )


    return series


def create_lag_features(
    series: pd.Series,
    lag_count: int,
) -> tuple[pd.DataFrame, pd.Series]:
    """
    過去lag_count件のbpsから、
    現在時刻のbpsを予測するデータを作成する。
    """
    data = pd.DataFrame(index=series.index)


    for lag in range(1, lag_count + 1):
        data[f"lag_{lag}"] = series.shift(lag)


    data["target"] = series


    # 予測したい正解値が NaN の行は、教師データとして使えないため除外
    # 特徴量側のNaNはXGBoostにそのまま渡す
    data = data.dropna(
        subset=["target"],
        )


    feature_columns = [
        f"lag_{lag}"
        for lag in range(1, lag_count + 1)
    ]


    X = data[feature_columns]
    y = data["target"]


    return X, y


def main() -> None:
    series = load_prometheus_range_json(
        TRAIN_DATA_PATH,
    )


    X, y = create_lag_features(
        series,
        LAG_COUNT,
    )


    # 学習データと検証データを分ける
    split_index = int(
        len(X) * (1 - VALIDATION_RATIO)
    )


    # 学習と検証データそれぞれで入力データ(X)と正解データ(y)にわける
    X_train = X.iloc[:split_index]
    y_train = y.iloc[:split_index]
    X_validation = X.iloc[split_index:]
    y_validation = y.iloc[split_index:]


    # 学習パラメータ指定
    model = XGBRegressor(
        n_estimators=100,
        max_depth=3,
        learning_rate=0.1,
        random_state=42,
        n_jobs=1,
        missing=np.nan,
    )


    # 学習データだけでモデルを学習
    model.fit(
        X_train,
        y_train,
    )


    # 検証データを予測
    validation_predictions = model.predict(
        X_validation,
    )


    # 検証データの予測結果と正解値から誤差取得
    absolute_errors = np.abs(
        y_validation.to_numpy()
        - validation_predictions
    )


    # 検証データの予測誤差の平均を取得
    mae = float(
        np.mean(absolute_errors)
    )


    # 異常判定に使う予測誤差の閾値
    anomaly_threshold = float(
        np.percentile(
            absolute_errors,
            ANOMALY_PERCENTILE,
        )
    )


    # 保存先のフォルダがない場合、作成(k3sで管理する際、どのノードでPod起動しても問題ないように)
    MODEL_DIR.mkdir(
        parents=True,
        exist_ok=True,
    )


    # モデルを保存する
    model.save_model(MODEL_PATH)


    # モデルや学習データの傾向などをメタデータとして整理
    metadata = {
        "model_created_at": (
            datetime.now(timezone.utc).isoformat()
        ),
        "training_data_start": (
            series.index.min().isoformat()
        ),
        "training_data_end": (
            series.index.max().isoformat()
        ),
        "source_records": int(len(series)),
        "training_samples": int(len(X_train)),
        "validation_samples": int(len(X_validation)),
        "frequency": FREQ,
        "lag_count": LAG_COUNT,
        "lookback_seconds": LAG_COUNT * 30,
        "validation_ratio": VALIDATION_RATIO,
        "validation_mae_bps": mae,
        "anomaly_percentile": ANOMALY_PERCENTILE,
        "anomaly_threshold_bps": anomaly_threshold,
        "bps_min": float(series.min()),
        "bps_max": float(series.max()),
        "bps_mean": float(series.mean()),
        "bps_median": float(series.median()),
        "model_parameters": {
            "n_estimators": 100,
            "max_depth": 3,
            "learning_rate": 0.1,
            "random_state": 42,
            "n_jobs": 1,
        },
        "model_file": str(MODEL_PATH),
        "training_data_file": TRAIN_DATA_PATH,
    }


    # メタデータ書き出し
    with MODEL_META_PATH.open(
        "w",
        encoding="utf-8",
    ) as f:
        json.dump(
            metadata,
            f,
            ensure_ascii=False,
            indent=2,
        )


    print(f"model saved: {MODEL_PATH}")
    print(f"metadata saved: {MODEL_META_PATH}")
    print(f"source records: {len(series)}")
    print(f"training samples: {len(X_train)}")
    print(f"validation samples: {len(X_validation)}")
    print(f"validation MAE: {mae:,.2f} bps")
    print(
        "anomaly threshold: "
        f"{anomaly_threshold:,.2f} bps"
    )


if __name__ == "__main__":
    main()
プログラムの構造としては以下の図のようにシンプルな構成となっています。
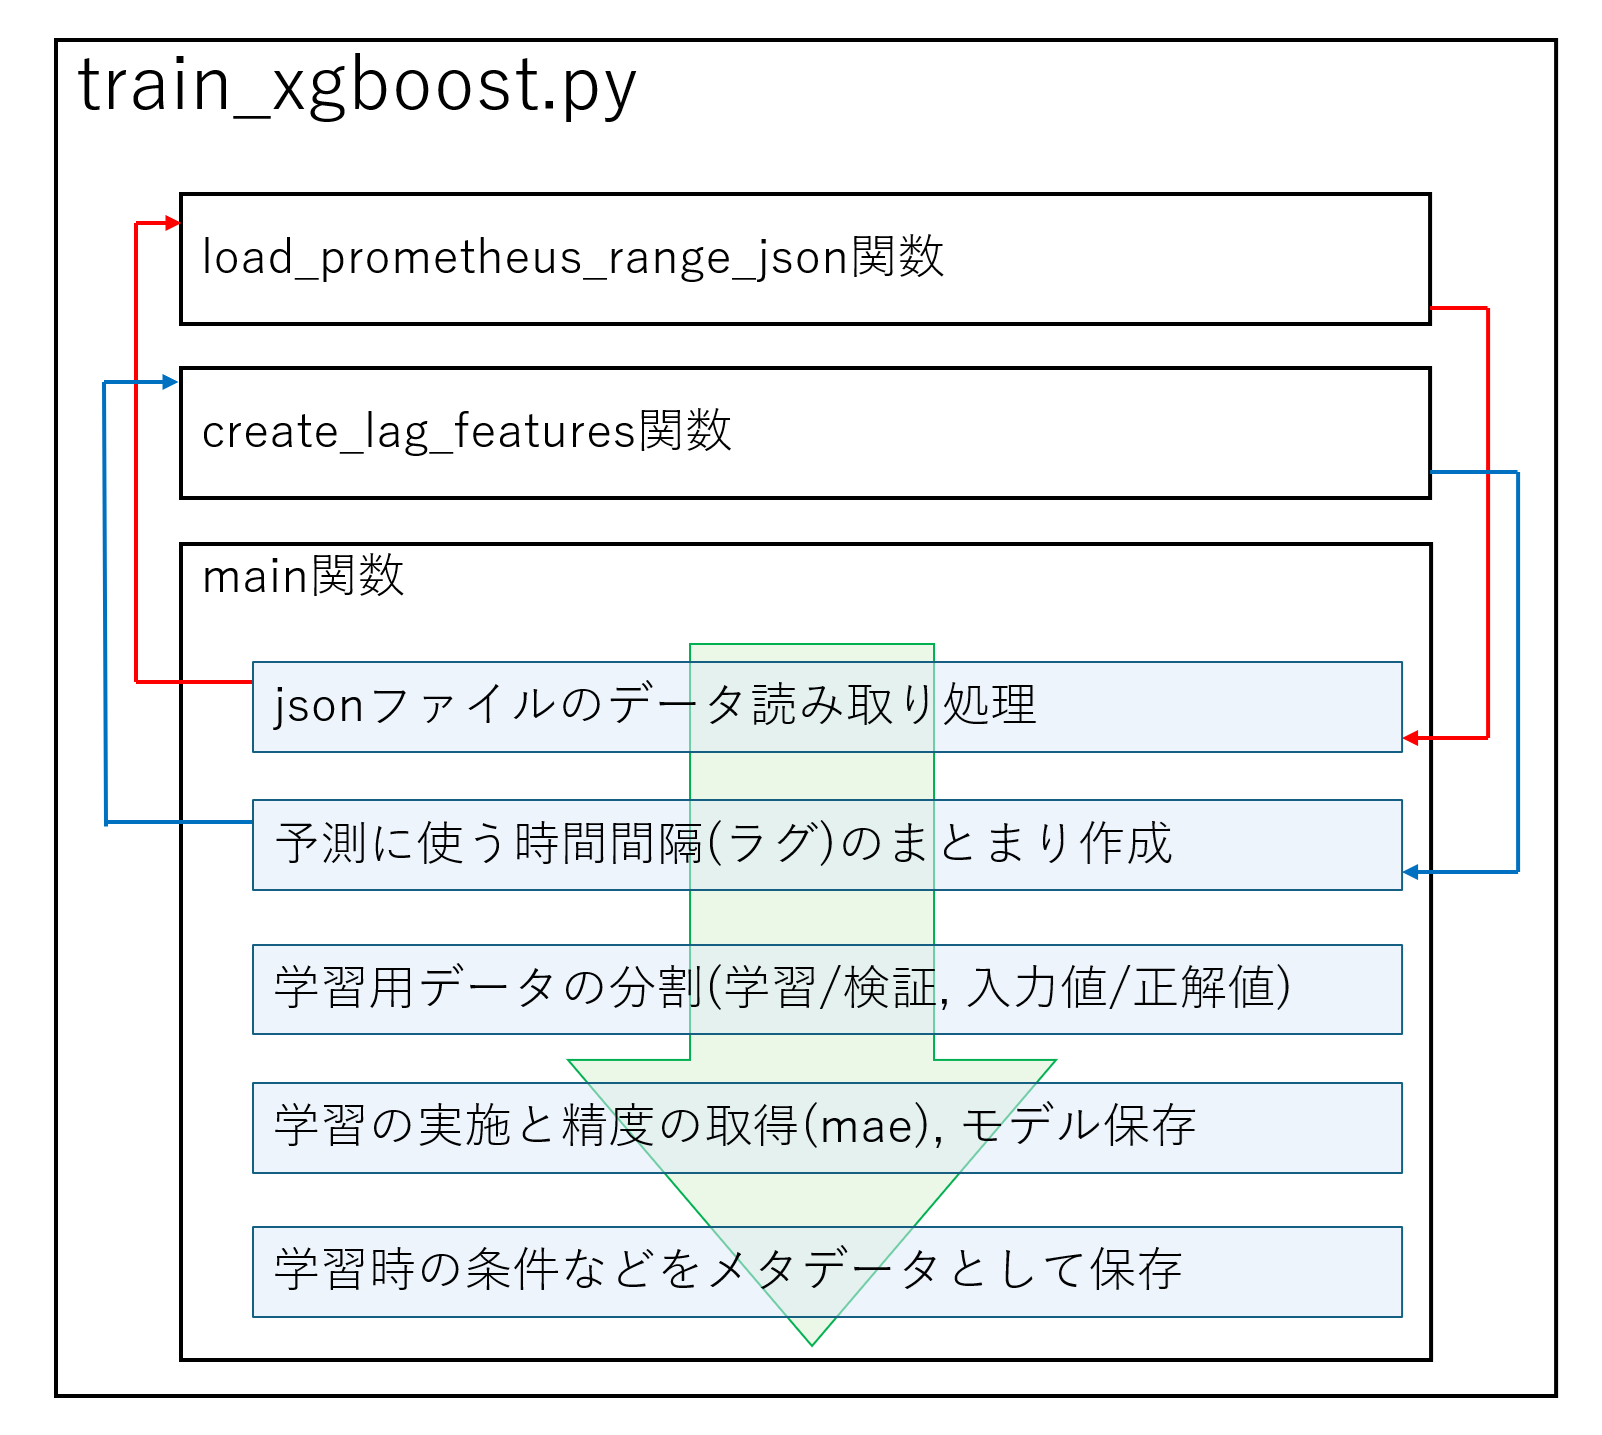
図3-1 train_xgboost.pyの大まかな処理の流れ
Prometheusからとってきたデータを読み取り、予測に使う時間単位へのデータ分割や欠損値対応(④ データの加工(前処理))をし、学習(⑤ 学習によるモデル作成)の後、できたモデルの評価(⑥ 精度確認)をしている、というのが大まかな流れです。
学習用のデータには、細かく言うと「学習データ」と「検証データ」があり、全データを学習データとはせず、一部を検証データとして利用する点は【LLM活用入門 第11回】で紹介した考え方と同様です。
学習データと検証データの割合は一般的に9:1や8:2が一般的ですが、今回は異常判定のライン設定に検証データの予測誤差(99パーセンタイル)を利用しています。
つまり検証データが少ないと予測誤差の粒度も大雑把となる為、今回は検証データも一定量確保したく、8:2という指定としています。
また、今回はモデルの再学習や複数のモデルの管理はしませんが、実運用だと定期的にモデルが更新されていくのが基本となるため、今動いている/用意されているモデルがどういう条件のものなのか後追いできるようにしておく仕組みが極めて重要になります。
今回のコード例でもメタデータとして出力する仕組みを取り入れています。
(ちなみにこのようなデータは異常検知された場合に「なぜ異常と判定されたか」分析するLLM問い合わせでも活用できます)
モデルの精度を評価するために、MAEと呼ばれる「予測誤差の平均値」もとっています。
この値の活用方法は、後述の実行例も踏まえて説明します。
ポイント/学習ツール
XGBoostの条件指定という観点で2点ポイントがあるので紹介します。
1点目は学習パラメータ(ハイパーパラメータ)についてです。
main関数のなかでXGBRegressor関数を使用してますが、ここで指定しているオプションの意味合いは以下の通りです。
| パラメータ | 説明 |
|---|---|
| n_estimators | 作成する決定木の数。100の決定木を順番に作り学習する(アンサンブル学習)。一般的に多いほど精度が高くなる(学習が進む)傾向にあるが、学習時間が増えたり過学習となる可能性もある。 |
| max_depth | 1本あたりの決定木の深さ。数値が大きいほど複雑な条件を学習しやすくなるが、学習時間が増えたり過学習となる可能性もある。 |
| learning_rate | 学習率。学習の進み幅。 |
| random_state | シード値。乱数固定用。 |
| n_jobs | 学習時に使用するCPUスレッド数。今回は1スレッドで実行。 |
| missing | 欠損値として扱う値。NaNを欠損値とする指定。 |
特に「n_estimators」「max_depth」「learning_rate」あたりは精度に影響を与えるパラメータで、精度改善のためのパラメータチューニングの対象になります。
2点目は「欠損値」の扱いについてです。
欠損値には大きく2つのパターンがあります。
1つは「推論に必要な7件のデータのうち、7件目(=予測したい値の実績値)がない場合」、もう1つは「1件目~6件目の直近の傾向データに欠損値が含まれている場合」です。
前者については学習時に「正解」を与えられなくなってしまうので学習データから除外する対応としています。
後者は、前者のように致命的な影響があるわけではないため、削除せずにあくまで欠損値として扱うものとしています。
実行例/学習ツール
学習用のPythonコードが用意できたので、実行してみましょう。
(myenv) $ python train_xgboost.py
---
model saved: /home/admin/xgboost/model/xgboost_model.json
metadata saved: /home/admin/xgboost/model/xgboost_model_meta.json
source records: 720
training samples: 576
validation samples: 144
validation MAE: 139,003.87 bps
anomaly threshold: 399,626.74 bps
---
結果表示から問題なくモデルができていそうです。
| [補足3] モデルの処理時間について 一般的にAIの処理は推論より学習のほうが重いといわれています。 実際に学習にかかった時間はn_jobs=1(CPUスレッドは1つのみ使用)という条件を指定していますが、1秒程度となりました。 軽量なモデルは処理が軽い一方で精度は荒くなりがちです。 |
|---|
出力されたメタデータを確認してみます。
(myenv) $ cat model/xgboost_model_meta.json
---
{
  "model_created_at": "2026-07-01T11:05:11.824120+00:00",
  "training_data_start": "2026-01-11T00:00:00+00:00",
  "training_data_end": "2026-07-01T05:59:30+00:00",
  "source_records": 720,
  "training_samples": 576,
  "validation_samples": 144,
  "frequency": "30s",
  "lag_count": 6,
  "lookback_seconds": 180,
  "validation_ratio": 0.2,
  "validation_mae_bps": 139003.86522172028,
  "anomaly_percentile": 99,
  "anomaly_threshold_bps": 399626.73557078006,
  "bps_min": 90000.0,
  "bps_max": 1280000.0,
  "bps_mean": 658422.9200523959,
  "bps_median": 657381.9869135,
  "model_parameters": {
    "n_estimators": 100,
    "max_depth": 3,
    "learning_rate": 0.1,
    "random_state": 42,
    "n_jobs": 1
  },
  "model_file": "/home/admin/xgboost/model/xgboost_model.json",
  "training_data_file": "traindata.json"
}
---
メタデータにある結果(データ傾向やMAEの結果)から精度に関する考察をしてみましょう。
まずデータ傾向から見てみます。
「bps_min/max/mean/median」を確認すると、平均値(mean)と中央値(median)はほぼ同じ値となっています。(約660Kbps)
このことから、概ね660Kbps前後を中心に分布しているデータと考えられます。
一方、最小値は90Kbps, 最大値は1.28Mbpsとなっており、頻度はそこまで多くないものの大きめのばらつきが発生していることもわかります。
iperfの設定では900K~1100Kの範囲でランダムにパケット出力をかけていましたが、データの平均としては660Kbpsなので、試験トラヒック用サーバでのiperf結果でも触れた通り、iperfの出力自体は不安定さがあるように見えます。
それが最大値/最小値のばらつきの大きさにつながっているものと考えられます。
一般的な傾向としてデータのばらつきが大きい場合、予測誤差も大きくなる傾向にあります。
次にMAEも含めて確認します。
MAEの結果、つまり予測精度の誤差平均は139Kbps程度となっていますが、データ自体の平均は660Kbpsである為、大体平均して21%程度(139Kbps÷660Kbps)、誤差が出ることがわかります。
予測結果と実績のズレが平均して2割程度という値をどう捉えるかですが、今回はトラヒックが時折大きく値が変動することも加味すると、感覚的にはそこそこレベルかなと思います。
より精度を高めるのであれば学習データを増やしたり、パラメータチューニングを行うことが選択肢となります。
異常と判定する予測誤差の値は「anomaly_threshold_bps」に表示されており、約400Kbpsです。
これが学習時に、検証データで精度確認をして99パーセンタイルで取得したラインの値となります。
つまり、この値だけ予測と実績値でずれると異常と判定されます。
これも、トラヒック変動が大きい場合があるというデータ傾向に加え、99パーセンタイルを選択していることもあり、大きめの値が出ています。
予測値に対して実績値が大きく外れた場合に異常とする条件になっていることがわかるかと思います。
このようにデータ傾向(ばらつきが多い/少ない)も加味した上で判定値も機械が自動で算出してくれます。
4. 推論ツール
⑦ AIモデルの利用(推論)
学習によりモデルができたので、活用フェーズに進みます。
AI利用を進めるためのステップとしてはこれが最後となります。
ここでは用意したモデルで異常判定を行う為の推論ツールを用意します。
今回も「学習ツール」の時と同様に、「コードと処理の概要」「ポイント」「実行例」の流れで紹介します。
コードと処理の概要/推論ツール
推論用のコードを以下に示します。(ポイントは後述します)
(myenv) $ vim infer_xgboost.py
import argparse
import json
import subprocess
import sys
import time
from pathlib import Path


import pandas as pd
import requests
from xgboost import XGBRegressor


# 各種パス指定
MODEL_PATH = Path("/home/admin/xgboost/model/xgboost_model.json")
MODEL_META_PATH = Path("/home/admin/xgboost/model/xgboost_model_meta.json")
ANOMALY_REPORT_DIR = Path("/home/admin/xgboost/anomaly_reports")
ROUTE_SWITCH_TOOL = Path("/home/admin/managed/route_switch.py")


# Prometheus関連
PROM_URL = "http://localhost:30090"
QUERY = ("rate(sonic_counters_ethernet4_SAI_PORT_STAT_IF_IN_OCTETS[30s]) * 8")


FREQ_SECONDS = 30


def get_evaluation_timestamp() -> int:
    """
    現在時刻を直前の30秒境界に切り下げる。
    """
    now = int(time.time())
    return now - (now % FREQ_SECONDS)


def fetch_recent_bps(evaluation_timestamp: int,lag_count: int,) -> pd.Series:
    """
    Prometheusから過去lag_count件と、判定対象の実測値1件を取得する。
    """
    # 現在時刻から、推論で必要なデータの開始時点を算出し、Prometheusから取得
    start_timestamp = (
        evaluation_timestamp - lag_count * FREQ_SECONDS
    )


    response = requests.get(
        f"{PROM_URL}/api/v1/query_range",
        params={
            "query": QUERY,
            "start": start_timestamp,
            "end": evaluation_timestamp,
            "step": f"{FREQ_SECONDS}s",
        },
        timeout=10,
    )


    response.raise_for_status()


    raw = response.json()
    results = raw["data"]["result"]


    if not results:
        raise RuntimeError(
            "Prometheusからデータを取得できませんでした"
        )


    values = results[0]["values"]


    df = pd.DataFrame(
        values,
        columns=["timestamp", "bps"],
    )


    df["timestamp"] = pd.to_datetime(
        df["timestamp"],
        unit="s",
        utc=True,
    )


    df["bps"] = pd.to_numeric(
        df["bps"],
    )


    series = (
        df.set_index("timestamp")
        .sort_index()["bps"]
    )


    # 30秒間隔の期待時刻を作成する
    expected_index = pd.date_range(
        start=pd.to_datetime(
            start_timestamp,
            unit="s",
            utc=True,
        ),
        end=pd.to_datetime(
            evaluation_timestamp,
            unit="s",
            utc=True,
        ),
        freq="30s",
    )


    # 存在しない過去値はNaNになる
    return series.reindex(expected_index)


def save_anomaly_report( anomaly_result: dict, ) -> Path:
    """
    AI異常結果レポートをJSON形式で保存する。
    """
    # 保存先のフォルダがない場合、作成する(k3s対策)。
    ANOMALY_REPORT_DIR.mkdir(
        parents=True,
        exist_ok=True,
    )


    report_path = (
        ANOMALY_REPORT_DIR / f"{anomaly_result['anomaly_id']}.json"
    )


    with report_path.open(
        "w",
        encoding="utf-8",
    ) as f:
        json.dump(
            anomaly_result,
            f,
            ensure_ascii=False,
            indent=2,
        )


    return report_path


def execute_route_switch( anomaly_id: str, ) -> None:
    """
    経路切替ツールへ異常IDを渡して実行する。
    """
    subprocess.run(
        [
            sys.executable,
            str(ROUTE_SWITCH_TOOL),
            anomaly_id,
        ],
        check=True,
        timeout=30,
    )


def main() -> None:
    # テストモードの用意
    parser = argparse.ArgumentParser()
    parser.add_argument(
        "--test",
        action="store_true",
        help=("試験モード。推論と異常判定のみ実施し、異常レポート作成と経路切替は行わない。"),
    )


    args = parser.parse_args()
    test_mode = args.test


    # メタデータファイルの読み取りと必要箇所の取得
    with MODEL_META_PATH.open(
        "r",
        encoding="utf-8",
    ) as f:
        metadata = json.load(f)


    lag_count = int(metadata["lag_count"])
    anomaly_threshold = float(metadata["anomaly_threshold_bps"])


    # モデルのロード
    model = XGBRegressor()
    model.load_model(MODEL_PATH)


    # 現在時刻を直前の30秒境界に丸め、今回の評価時刻として利用する
    evaluation_timestamp = (
        get_evaluation_timestamp()
    )


    # 推論用のデータを準備
    series = fetch_recent_bps(
        evaluation_timestamp,
        lag_count,
    )


    # 最後の値が判定対象の実測値の為、actual_bpsとして扱う
    actual_bps = series.iloc[-1]


    if pd.isna(actual_bps):
        raise RuntimeError(
            "判定対象時刻の実測値がありません"
        )


    # 最後の値を除いた過去6件を直前の傾向(モデルへの入力値)として扱う
    lag_values = series.iloc[:-1]


    # 推論用にDataFrame形式にデータ変換
    X = pd.DataFrame(
        [list(reversed(lag_values.to_list()))],
        columns=[
            f"lag_{i}"
            for i in range(1, lag_count + 1)
            ],
        )


    # 推論実施
    predicted_bps = float(model.predict(X)[0])


    # 実績値 - AIの予測値の差分(予測誤差)取得
    error_bps = abs(
        float(actual_bps) - predicted_bps
    )


    # 異常判定(予測値と実測値の差分が、学習時に算出したしきい値を超えたら異常と判定)
    is_anomaly = (
        error_bps > anomaly_threshold
    )


    result_data = {
        "timestamp": series.index[-1].isoformat(),
        "actual_bps": float(actual_bps),
        "predicted_bps": predicted_bps,
        "error_bps": error_bps,
        "anomaly_threshold_bps": anomaly_threshold,
        "missing_lag_values": int(
            lag_values.isna().sum()
        ),
        "is_anomaly": bool(is_anomaly),
    }


    print(
        json.dumps(
            result_data,
            ensure_ascii=False,
            indent=2,
        )
    )


    # 異常と判定された場合の処理
    if is_anomaly:
        # 異常ID払い出し
        anomaly_id = (
            "ANOMALY-" + series.index[-1].strftime("%Y%m%dT%H%M%SZ")
        )


        # 異常レポートを作成し、保存(試験モードでは作成しない)
        anomaly_result = {
            "anomaly_id": anomaly_id,
            **result_data,
        }


        if test_mode:
            print("[TEST] 上の通り異常と判定されましたが、異常レポート作成と経路切替は実施しません。")
            return


        report_path = save_anomaly_report(anomaly_result)
        print(f"anomaly report saved: {report_path}")


        # 経路切り替えツール起動
        execute_route_switch(anomaly_id)


if __name__ == "__main__":
    main()
推論ツールは、関数が増えたことで学習ツールと比較し少し複雑になったように見えるかもしれません。
しかし実施している処理は極めてシンプルです。
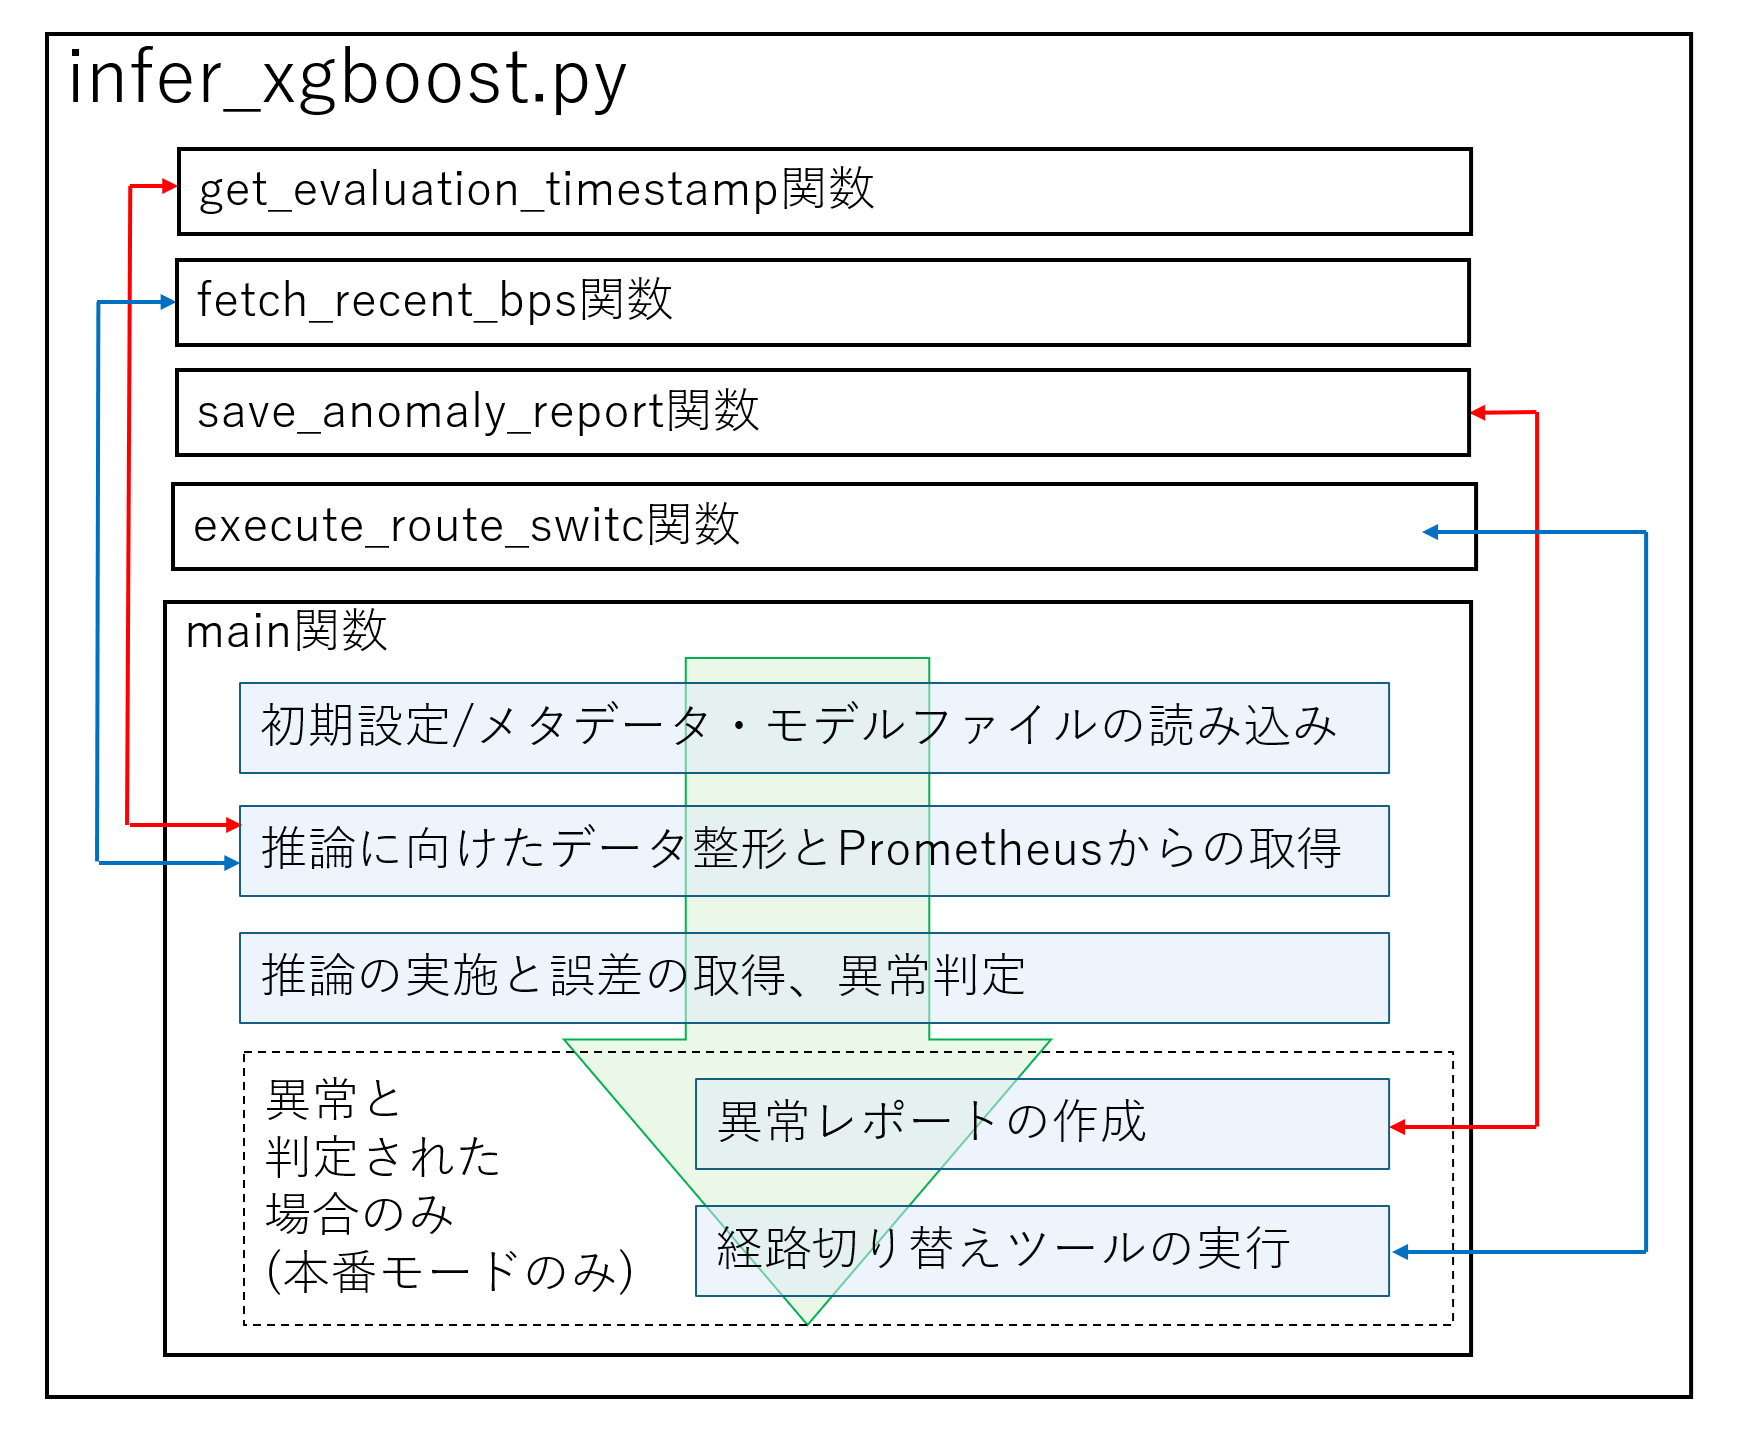
図4-1 infer_xgboost.pyの大まかな処理の流れ
推論処理は学習でできたモデルとメタデータを活用します。
活用するものを読み込んだ後、Prometheusから分析対象となる最新データを取得し、AIによる判定/推論(⑦ AIモデルの利用(推論))を行います。
また、推論時に異常と判定された場合は、異常判定レポートを生成の上、経路切り替えツール(制御ツール)を呼び出します。
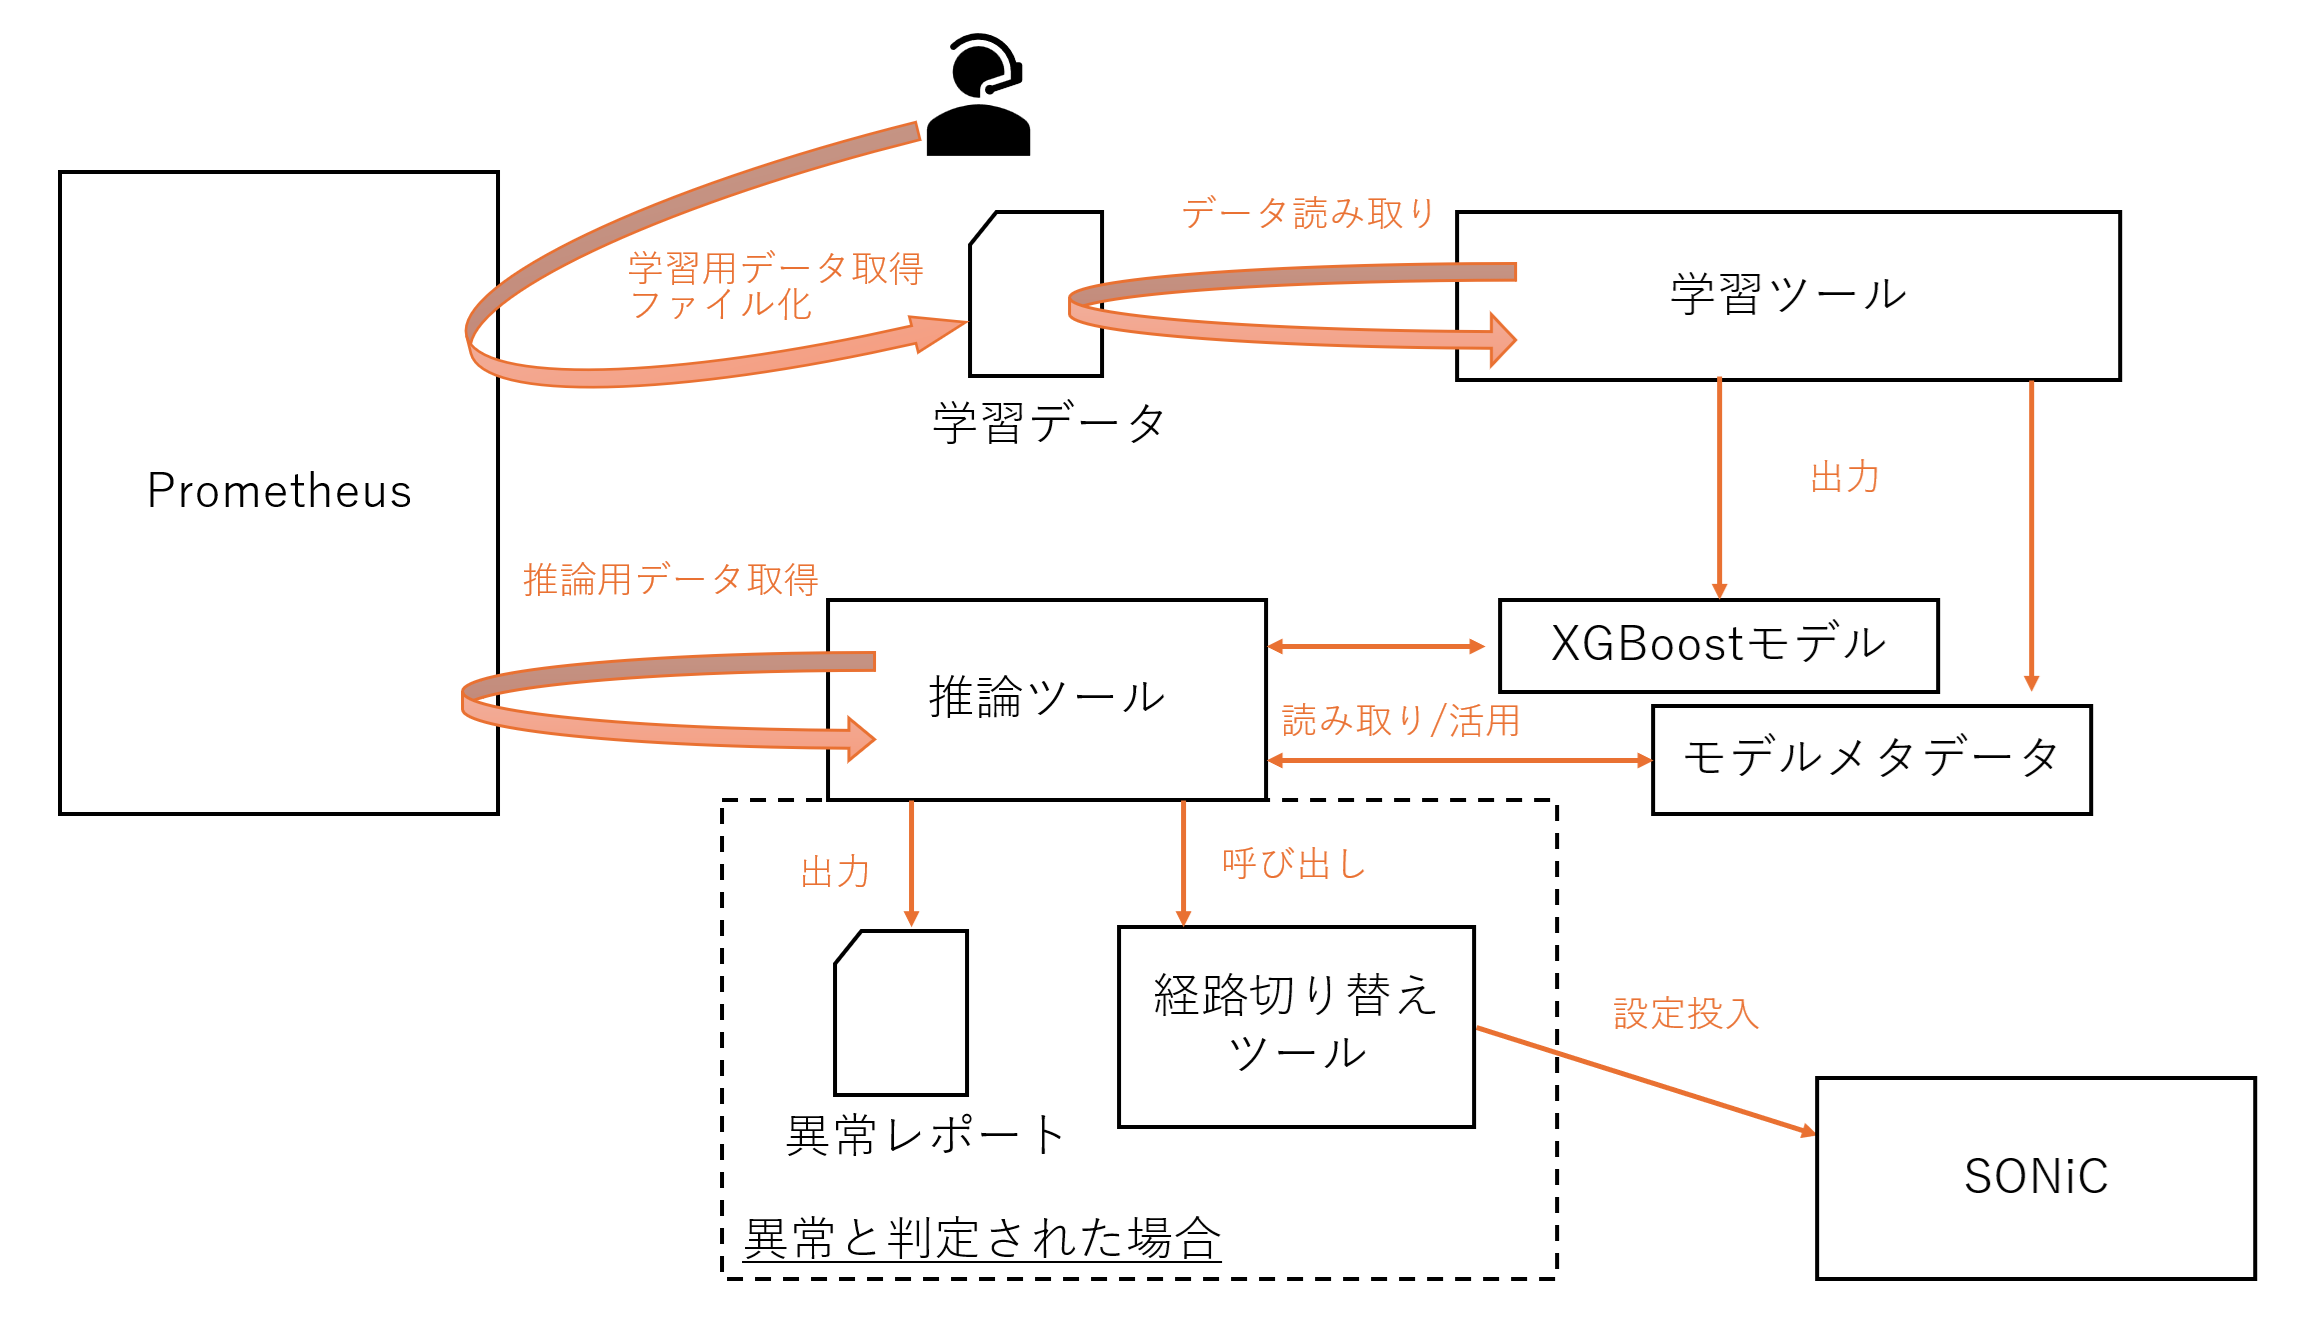
図4-2 各ツールの連携イメージ
推論ツールと経路切り替えツールもk3sで別々に管理するのであれば、本来はAPIなどで連携できるようにしておくのがベストかと思いますが、今回はシンプルに直接実行としています。
前述の通り推論ツールで異常と判定された場合、経路切り替えツールと連動して動きます。
ツール単体の動作確認目的にも利用できるように、これまで説明してきた「本番モード」の他に、--testオプションを指定して動かす「試験モード」を実装しています。
本番モードとの動作の違いとしては、異常判定された際に異常レポート作成と経路切り替えツールの呼び出しをしないだけです。(正常判定の場合は動作は同じです)
ポイント/推論ツール
推論自体は学習時と同様の条件で予測(直近3分間のトラヒック傾向をもとに、現在のbpsを予測)をしています。
学習で使ったモデルを利用する点と、学習で取得した99パーセンタイルの値(anomaly_threshold_bps)を利用する点以外、特筆して触れるべきポイントもありませんが、本ツールについて2点ほど説明しておきたいポイントがあります。
まず1点目は「get_evaluation_timestamp関数」です。
コメントに書かれた内容だけだとイメージがわかないかと思うので、ここで例を紹介します。
例えば現在の時刻が12:00:12だった場合、この値をそのまま今回の30秒周期の条件(rate(...[30s]))でPrometheusから取得すると直近の値は11:59:42~ 12:00:12の範囲の値となります。
これでは中途半端ですし、実行タイミングによって範囲が異なってしまいます。
そこで、いつ実行しても30秒ごとの単位(例えば11:59:00~11:59:30や11:59:30~12:00:00)に時刻を揃えると良いでしょう。
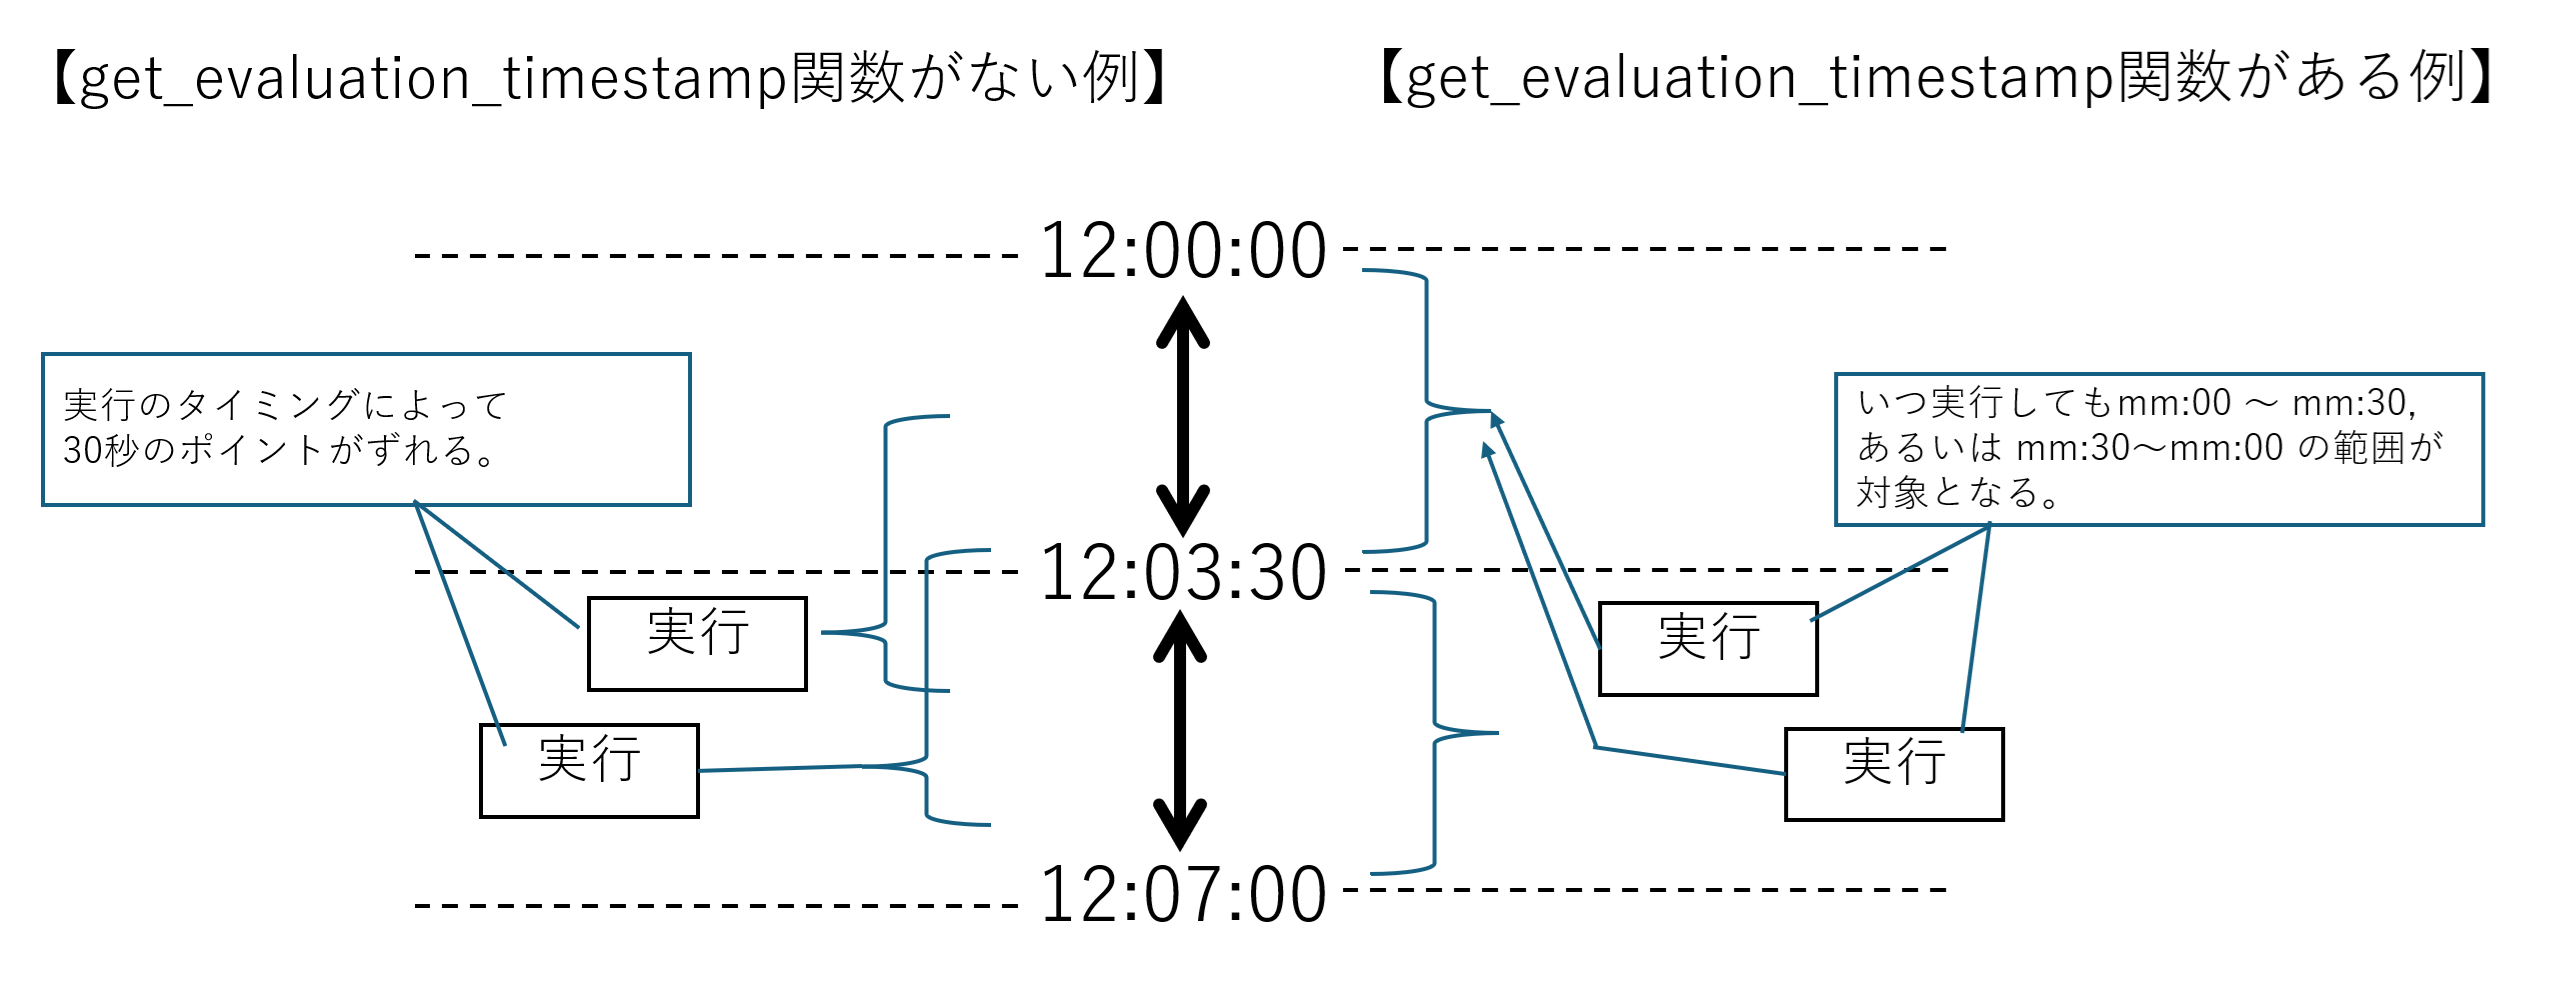
図4-3 get_evaluation_timestamp関数の有無による動作差分
したがって、ここでは30秒単位の値に切り下げる処理を実施(12:00:12であれば、12:00:00になります)し、その値をもとにPrometheusに値取得依頼をかけています。
なお、最も直近の値(この例では12:00:00)の値がない場合は、推論する値の実績値がわからないため、エラーとする処理をツール内に入れています。
推論する値の実績値より、さらに前の3分分のデータについては欠損値の場合は学習時と同様に欠損値を示す「NaN」として扱われます。
2点目は異常レポートについてです。
異常と判定された場合には「どのような値を受け取って、どう異常と判定されたか」がわかるような記録を残しておくとよいでしょう。
今回は「推論対象となった値の時刻と実績値、AIの予測値、予測誤差、異常と判断する誤差値、NaN(欠損値)の数」などを表示する形としています。
今回は1つのモデルのみしか使いませんが、複数モデルを利用する場合はモデルIDやモデルのメタデータファイルなども追えるようにしておけると「どのモデルを使ったのか」が追えるようになる為、良いでしょう。
実際の異常レポートの出力結果は第5回の「検証シナリオの実施と結果」章にて紹介します。
実行例/推論ツール
ではツールの用意ができたら、試験モードで動かしてみましょう。
あくまで試験目的のモードである為、異常と判定されても異常レポートの生成も異常IDも払い出されません。
# 正常判定時
(myenv) $ python infer_xgboost.py --test
---
{
  "timestamp": "2026-07-01T11:12:30+00:00",
  "actual_bps": 542794.3397169858,
  "predicted_bps": 261854.578125,
  "error_bps": 280939.7615919858,
  "anomaly_threshold_bps": 399626.73557078006,
  "missing_lag_values": 0,
  "is_anomaly": false
}
---


# 異常判定時
(myenv) $ python infer_xgboost.py --test
---
{
  "timestamp": "2026-07-01T11:19:00+00:00",
  "actual_bps": 80358.38208089594,
  "predicted_bps": 669690.9375,
  "error_bps": 589332.555419104,
  "anomaly_threshold_bps": 399626.73557078006,
  "missing_lag_values": 0,
  "is_anomaly": true
}
[TEST] 上の通り異常と判定されましたが、異常レポート作成と経路切替は実施しません。
---
問題なく推論ができたことが確認できました。
5. 経路切り替えツール
最後に、AIにて異常と判定された場合に呼び出される経路切り替えツールを用意します。
今回は事前準備もあるので、「事前準備」「コードと処理の概要」「ポイント」「実行例」という流れで紹介していきます。
事前準備/経路切り替えツール
経路切り替えツールの配置場所は、AI用のフォルダとは分けて配置します。
(myenv) $ mkdir /home/admin/xgboost/anomaly_reports
(myenv) $ mkdir /home/admin/managed
(myenv) $ mkdir /home/admin/managed/log
(myenv) $ mkdir /home/admin/managed/state
事前準備はこれで完了です。
コードと処理の概要/経路切り替えツール
今回、経路切り替えツールでは、対象機器に対してSSHでつないでコマンドを入れる、というシンプルな方法で設定投入/経路切り替えを実現します。
ソースコードを以下に示します。(ポイントは後述します)
(myenv) $ vim /home/admin/managed/route_switch.py
import argparse
import json
import logging
import sys
from datetime import datetime, timezone
from pathlib import Path
import paramiko


# SONiC接続情報
SONIC_HOST = "192.168.56.101"
SONIC_PORT = 22
SONIC_USERNAME = "admin"
SONIC_PASSWORD = "YourPaSsWoRd"


# 切替対象経路
DESTINATION = "10.10.99.1/32"
DESTINATION_IP = "10.10.99.1"


# 経路情報
ROUTE_A = {
    "gateway": "10.10.11.1",
    "interface": "eth3",
}


ROUTE_B = {
    "gateway": "10.10.12.1",
    "interface": "eth4",
}


# ログ・状態ファイル
LOG_PATH = Path("/home/admin/managed/log/route_switch.log")
STATE_DIR = Path("/home/admin/managed/state")
STATE_PATH = STATE_DIR / "route_switch_state.json"


# 前回の切替成功から5分間は再切替しない
COOLDOWN_SECONDS = 300


def setup_logger() -> logging.Logger:
    """
    ログ出力に関するセットアップを行う。
    """
    logger = logging.getLogger("route_switch")
    logger.setLevel(logging.INFO)


    if not logger.handlers:
        handler = logging.FileHandler(
            LOG_PATH,
            mode="a",
            encoding="utf-8",
        )


        formatter = logging.Formatter(
            "%(asctime)s %(message)s"
        )


        handler.setFormatter(formatter)
        logger.addHandler(handler)


    return logger


def is_in_cooldown() -> bool:
    """
    stateファイルを読み、前回切替から5分未満ならTrueを返す。
    """
    if not STATE_PATH.exists():
        return False


    with STATE_PATH.open(
        "r",
        encoding="utf-8",
    ) as f:
        state = json.load(f)


    last_switched_at = datetime.fromisoformat(
        state["last_switched_at"]
    )


    elapsed_seconds = (
        datetime.now(timezone.utc) - last_switched_at
    ).total_seconds()


    return elapsed_seconds < COOLDOWN_SECONDS


def connect_to_ne() -> paramiko.SSHClient:
    """
    設定投入先の機器との接続を行う。
    """
    client = paramiko.SSHClient()


    # known_hostsに接続先情報がない場合も接続する。
    client.set_missing_host_key_policy(
        paramiko.AutoAddPolicy()
    )


    client.connect(
        hostname=SONIC_HOST,
        port=SONIC_PORT,
        username=SONIC_USERNAME,
        password=SONIC_PASSWORD,
        look_for_keys=False,
        allow_agent=False,
        timeout=10,
    )


    return client


def run_command(client: paramiko.SSHClient,command: str,use_sudo: bool = False,) -> str:
    """
    渡されたコマンドを実施し、実行結果を返す。
    """
    # 接続先に対しコマンド実行し、標準入力・標準出力・標準エラー出力を取得。
    stdin, stdout, stderr = client.exec_command(
        command,
        timeout=10,
        get_pty=use_sudo,
    )


    # コマンドの終了コードを取得
    exit_code = stdout.channel.recv_exit_status()


    output = stdout.read().decode("utf-8").strip()
    error = stderr.read().decode("utf-8").strip()


    # 終了コードが0以外の場合はエラーとして扱う
    if exit_code != 0:
        raise RuntimeError(
            f"コマンド実行に失敗しました: {error}"
        )


    return output


def get_current_route(client: paramiko.SSHClient,) -> dict:
    """
    対象機器の現在の経路設定を確認する。
    """
    # 経路確認コマンドを実行
    route_text = run_command(
        client,
        f"ip -4 route show {DESTINATION}",
    )


    if not route_text:
        raise RuntimeError(
            f"{DESTINATION}の経路がありません"
        )


    words = route_text.split()


    try:
        # コマンド取得結果から必要な個所を抜き出す。(GW情報とIF情報を取得)
        gateway = words[words.index("via") + 1]
        interface = words[words.index("dev") + 1]


    except (ValueError, IndexError) as exc:
        raise RuntimeError(
            f"経路情報を解析できません: {route_text}"
        ) from exc


    return {
        "gateway": gateway,
        "interface": interface,
        "raw": route_text,
    }


def get_target_route(current_route: dict,) -> dict:
    """
    現在の設定から、どのような設定をパターンで設定するか判定する。
    現在AならB、現在BならAを返す。
    """
    if (
        current_route["gateway"] == ROUTE_A["gateway"]
        and current_route["interface"] == ROUTE_A["interface"]
    ):
        return ROUTE_B


    if (
        current_route["gateway"] == ROUTE_B["gateway"]
        and current_route["interface"] == ROUTE_B["interface"]
    ):
        return ROUTE_A


    raise RuntimeError(
        "現在経路が想定したA/Bのいずれでもありません: "
        f"{current_route['raw']}"
    )


def switch_and_verify_route(client: paramiko.SSHClient, target_route: dict,) -> None:
    """
    経路を切り替え、切替後の経路を確認する。
    """
    # 実行するコマンド組み立て
    command = (
        "sudo -S -p '' ip route replace "
        f"{DESTINATION} "
        f"via {target_route['gateway']} "
        f"dev {target_route['interface']}"
    )


    # コマンド実行
    run_command(
        client,
        command,
        use_sudo=True,
    )


    # 設定後の経路情報を取得し、正しく切り替わっていることを確認。
    switched_route = get_current_route(client)


    if (
        switched_route["gateway"] != target_route["gateway"]
        or switched_route["interface"]
        != target_route["interface"]
    ):
        raise RuntimeError(
            "切替後の経路確認に失敗しました: "
            f"{switched_route['raw']}"
        )


def save_switch_state(anomaly_id: str, current_route: dict, target_route: dict,) -> None:
    """
    経路切替の記録をstateファイルとして保存する。
    """
    # 保存先のフォルダがなければ作成。(k3s化した際の対策)
    STATE_DIR.mkdir(
        parents=True,
        exist_ok=True,
    )


    state = {
        "last_switched_at": (
            datetime.now(timezone.utc).isoformat()
        ),
        "anomaly_id": anomaly_id,
        "destination": DESTINATION,
        "from_interface": current_route["interface"],
        "to_interface": target_route["interface"],
    }


    with STATE_PATH.open(
        "w",
        encoding="utf-8",
    ) as f:
        json.dump(
            state,
            f,
            ensure_ascii=False,
            indent=2,
        )


def main() -> None:
    # 試験モードの用意
    parser = argparse.ArgumentParser()
    parser.add_argument(
        "anomaly_id",
        nargs="?",
        help="異常ID。通常モードでは指定必須。",
    )
    parser.add_argument(
        "--test",
        action="store_true",
        help="試験モード。TEST IDを払い出し、実際に経路切替・ログ出力・state保存を行う。",
    )


    args = parser.parse_args()


    # モードに応じた異常IDの付与
    if args.test:
        anomaly_id = (
            "TEST-" + datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%SZ")
        )
    else:
        if not args.anomaly_id:
            raise RuntimeError("異常IDを指定してください")
        anomaly_id = args.anomaly_id


    logger = setup_logger()


    # stateファイルから前回の経路切り替え時刻を確認し、経過した時間が5分未満であれば切り替えを抑止する。
    if is_in_cooldown():
        message = (
            f"{anomaly_id}による経路切替は、"
            "前回の切替から5分未満のため抑止しました。"
        )


        logger.info(message)
        print(message)
        return


    # SONiCへSSH接続
    client = connect_to_ne()


    try:
        # 現在のSONiCの経路情報を確認し、それにより設定する経路情報を決める。
        current_route = get_current_route(client)
        target_route = get_target_route(current_route)


        # 経路切り替えの実施と設定後の確認
        switch_and_verify_route(
            client,
            target_route,
        )


    finally:
        client.close()


    # 経路切り替えをログとして記録(履歴として扱う)。
    message = (
        f"{anomaly_id}により、"
        f"宛先{DESTINATION_IP}を"
        f"{current_route['interface']}から"
        f"{target_route['interface']}に"
        "切り替えました。"
    )


    logger.info(message)


    # 今回の経路切り替え情報をstateファイルとして保存する。
    save_switch_state(
        anomaly_id,
        current_route,
        target_route,
    )


    print(message)


if __name__ == "__main__":
    try:
        main()


    except Exception as exc:
        print(
            "経路切替処理でエラーが発生しました: "
            f"{exc}",
            file=sys.stderr,
        )


        sys.exit(1)
本ツールは前述の推論ツールから呼び出されます。(その際には異常IDを渡されます)
処理の流れとしては以下のようになっています。
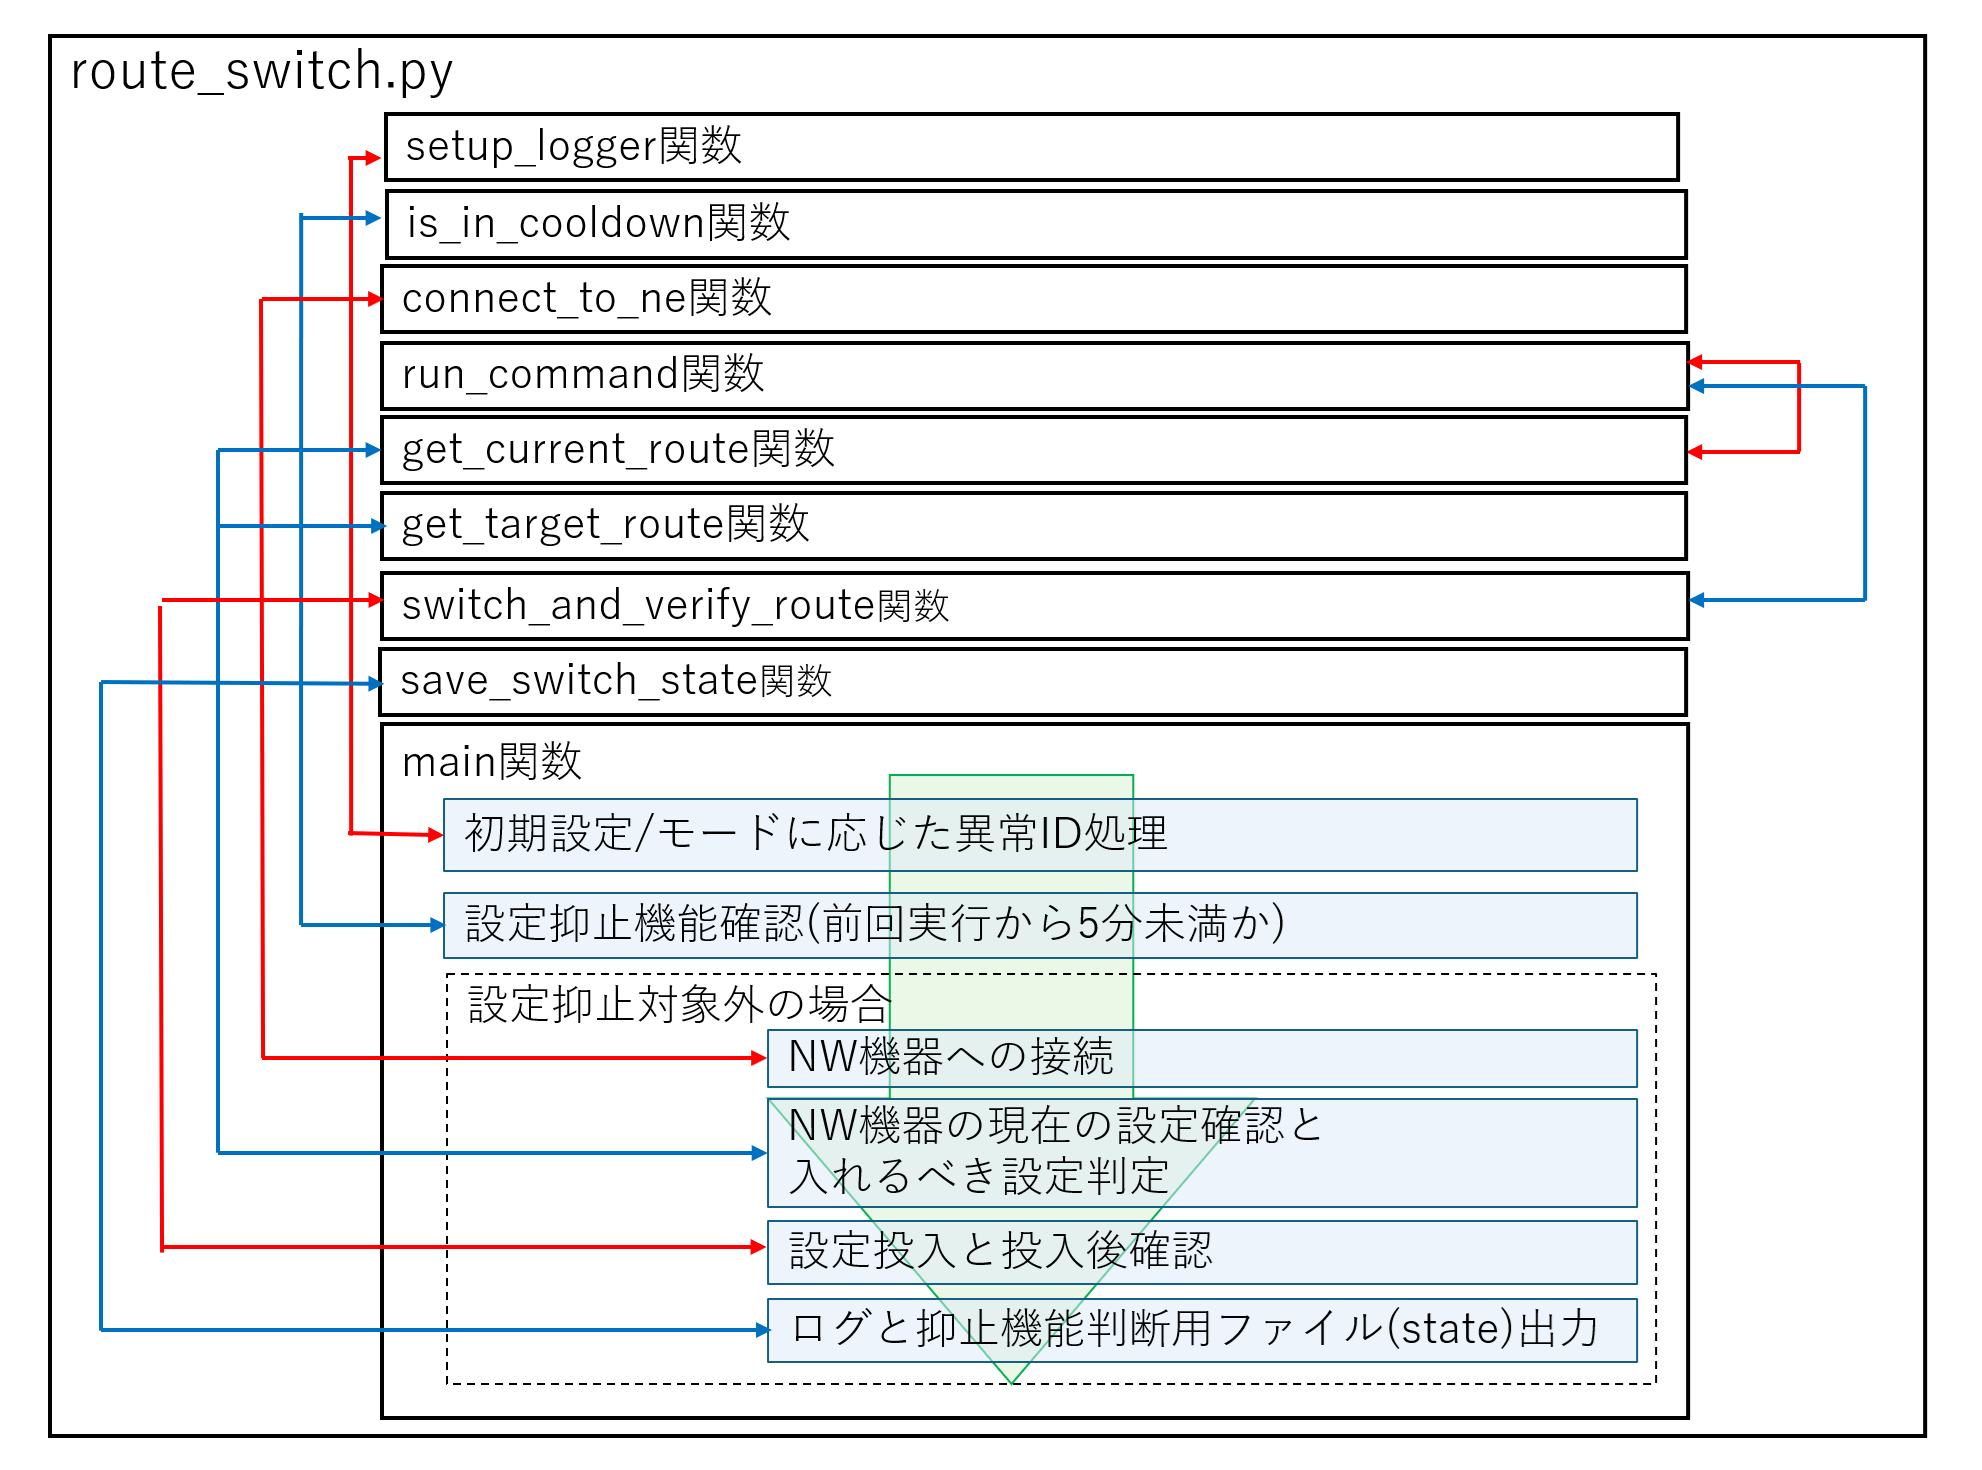
図5-1 route_switch.pyの大まかな処理の流れ
関数が多く一見複雑なように見えますが、実施内容はシンプルです。
まず、主たる役割である「設定投入」に関してはSONiCの今の設定がどちらの経路になっているか確認を行い、もう1つの設定を行う手順となっています。
ただし異常判定が何度もされると高頻度に経路が切り替わってしまいます。(いわゆる経路フラッピング)
今回はNW機器も少なく、影響が出やすい動的ルーティングも使ってはいないですが、この動作が良いこととも言えないため、切り替え頻度があまりに近い場合は抑止をかける処理も入れています。
具体的には5分抑止を行います。
また、本ツールも推論ツールと同様に「試験モード」を用意しています。
目的/用途は「本ツール単体での動作確認」となるため、本番モードでは異常IDを渡されますが、試験モードでは異常ID指定なしで動作可能です。
ただしNW機器への設定投入ができることも確認観点に入っている為、実際にSONiCの設定変更がされます。
ポイント/経路切り替えツール
「設定投入」と「抑止機能」についてもう少し説明します。
まず設定投入に関してですが、厳密なことをいえば事前の設定確認(現在設定されている情報確認)→設定投入→設定後の確認(投入した設定が反映されていることの確認) の流れで処理しています。
特に最後の「投入後の確認」は、投入コマンドの「正常終了を示すコマンド終了コード(ステータスコード)」だけで判定し、設定後の確認を省略する方法もあるかと思いますが、本当に正しく設定が反映されたかを確認する為、投入後の設定もチェックする形としています。
次に設定抑止機能についてです。
本機能を実現するためにstateファイル(route_switch_state.json)というファイルを活用しています。
これは経路切り替えをしたときの情報を書き込むもので、1ファイルしか存在しません。
つまり、直近の経路切り替えがどんなことをしたのかがわかるファイルです。
このファイルにある「経路切り替え時刻(last_switched_at)」と現在時刻を比較し、5分未満かどうかを判定します。
stateファイルは以下のような形で書き出されます。
{
  "last_switched_at": "2026-07-02T00:39:03.407377+00:00",
  "anomaly_id": "ANOMALY-20260702T003900Z",
  "destination": "10.10.99.1/32",
  "from_interface": "eth3",
  "to_interface": "eth4"
}
なお、経路切り替えの実施と抑止の履歴がわかるようにroute_switch.logとしてログを出力しています。
記録する内容はほぼ同一ですが、stateファイルとログの役割は異なります。
以下に違いを記載します。
| ファイル名 | 記録数 | 役割/目的 |
|---|---|---|
| route_switch_state.json | 直近に実施した経路切り替えのみ(抑止は含まない) | 経路切り替えツールの内部処理で利用。 |
| route_switch.log | 切り替え実施/抑止ともに実施ごとに記録。 | 切り替え/制御処理の履歴として保守者が活用する想定。 |
似たような内容を書いているので1ファイルにまとめることもできなくはないですが、保守者が見るファイルとシステムが処理に使うファイルは、誤操作による影響や将来の拡張性も加味し、分ける形としています。
試験モードではSONiCの経路が切り替わるため、抑止機能の対象ともするべく、stateファイルの書き出しも行います。
また、「試験目的でいつどう経路が切り替えたか」辿れるようにroute_switch.logとしても履歴を残します。
実行例/経路切り替えツール
では経路切り替えツールも試験モードで動作確認をしてみましょう。
# 異常IDを渡さずに試験モードで実行
(myenv) $ python /home/admin/managed/route_switch.py --test
---
TEST-20260702T005030Zにより、宛先10.10.99.1をeth3からeth4に切り替えました。
---


# stateファイル確認
(myenv) $ cat /home/admin/managed/state/route_switch_state.json
---
{
  "last_switched_at": "2026-07-02T00:50:30.481934+00:00",
  "anomaly_id": "TEST-20260702T005030Z",
  "destination": "10.10.99.1/32",
  "from_interface": "eth3",
  "to_interface": "eth4"
}
---


# 抑止機能の確認
(myenv) $ python /home/admin/managed/route_switch.py --test
---
TEST-20260702T005117Zによる経路切替は、前回の切替から5分未満のため抑止しました。
---
問題なく処理できたことを確認できました。
最後に、前述の検証により今はeth4経路に切り替わっているので、eth3に戻しておきましょう。
# 試験用途でstateファイルを消す
(myenv) $ rm /home/admin/managed/state/route_switch_state.json


# 再実行
(myenv) $ python /home/admin/managed/route_switch.py --test
---
TEST-20260702T005235Zにより、宛先10.10.99.1をeth4からeth3に切り替えました。
---
実際の経過時間は5分未満でしたが、処理が成功しました。
このように誤操作などでツール内で処理に使っているファイルを消すと機能が正常に動作しない場合がありえます。
その為、前述の通り保守者がさわるファイル(route_switch.log)とツールが扱うファイルで分けています。
| [補足5-1] 設定投入の難しさについて 今回の例は、条件に合致したらNW機器(SONiC)に設定を投入する、というシンプルな例で作られています。 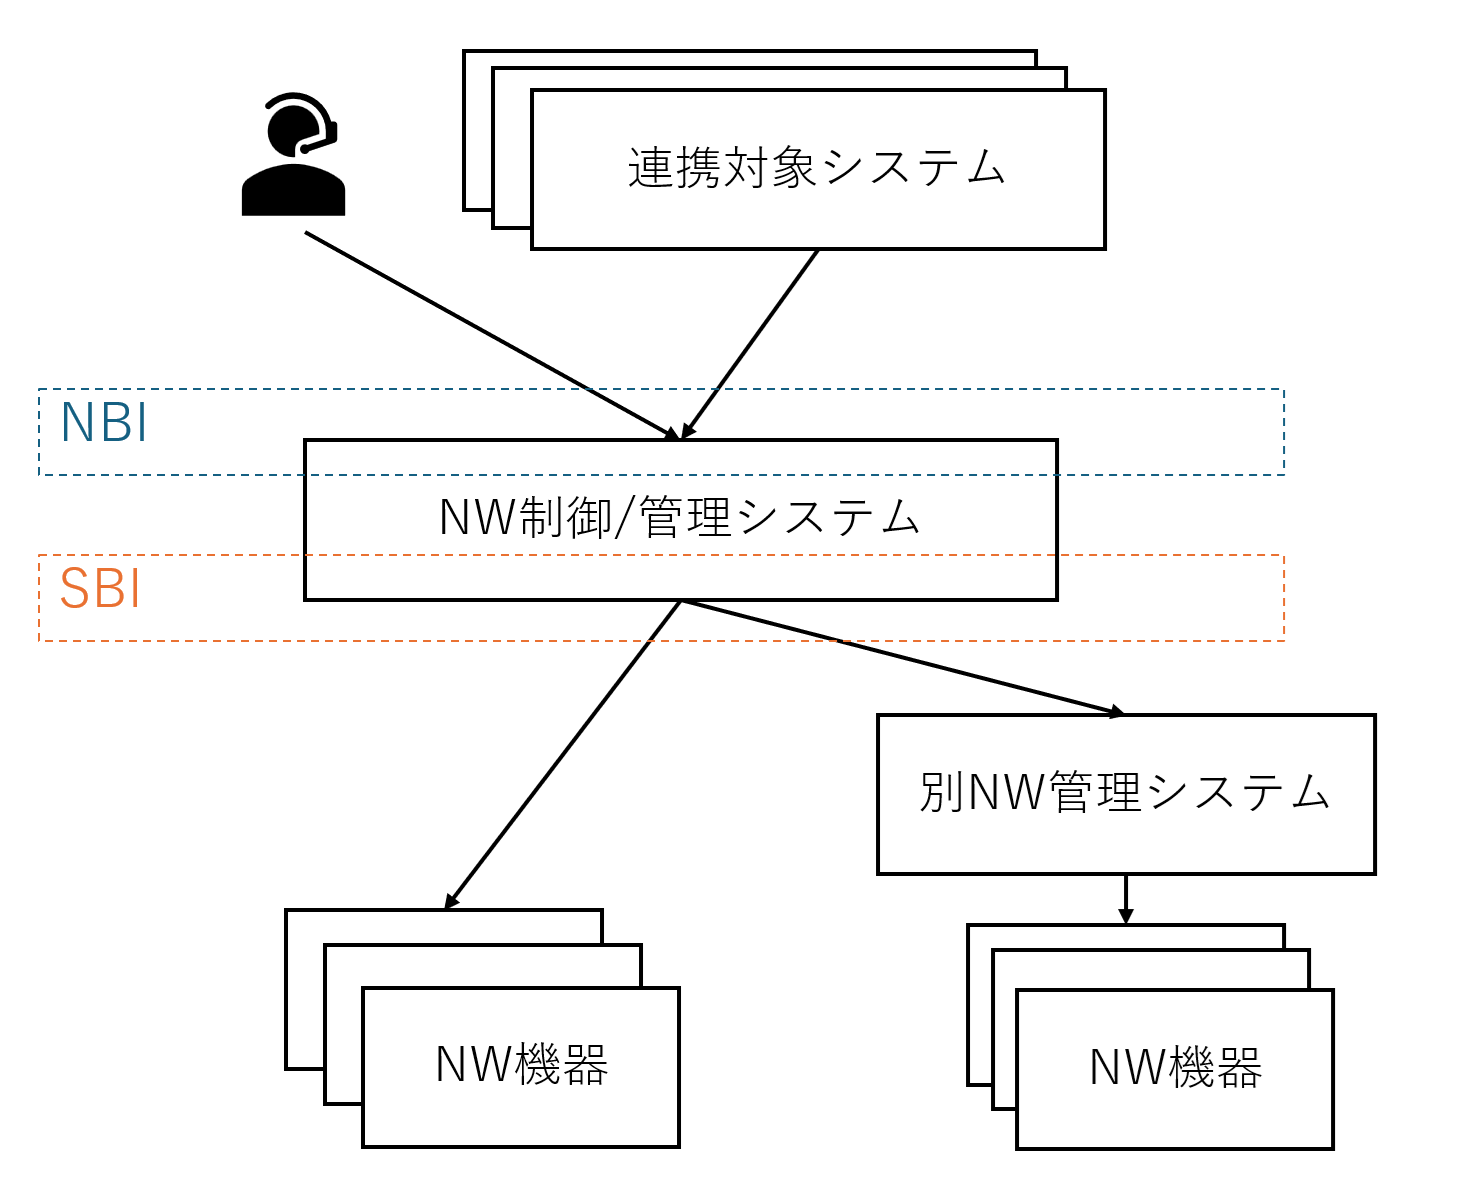
図5-2 NBI/SBIのイメージ また、NW機器への設定投入は「入れればいいだけ」のように見えますが、それ1つでサービスに影響が出てしまう可能性もある、リスクのある行為でもあります。 なお、設定投入についてもいつどのような設定を入れたのか、どれぐらい処理時間がかかったのかなどが後から追いやすいようにPrometheusなどに監視情報として登録しておくとよいでしょう。(本記事ではそこまでは対応しません) |
|---|
| [補足5-2] 複数の機器に対する設定投入について 今回は1台の機器への投入だけでしたが、時には複数台に似た設定を入れたいといったケースもあるでしょう。 例えば今回はDial-Inを使ったTelemetry収集を活用しているため、Telegrafで取得したいセンサーパスを指定しています。 このような場合、愚直に1台ずつ設定投入しても良いですが、Ansibleのようなツールを利用するのも選択肢になります。 ちなみに今回のNW機器への設定投入はSSH経由で実行していますが、Ansibleでは基本のSSHに加え、NETCONFやREST APIも利用できます。 また複数台のNW機器に対して正しく設定できるかどうか検証する際に、実物の台数を用意できない場合はcisshgoのようなツールを使うのもよいでしょう。 |
|---|
6. 定期実行の実現
各ツールの準備ができたので、定期実行をする為の準備をします。(ツールの連携動作確認は第5回の「検証シナリオの実施と結果」章にて扱います)
今回は定期実行のため、cronを活用します。
以下に準備手順を記載します。
(myenv) $ mkdir /home/admin/log


(myenv) $ EDITOR=vim crontab -e
---
* * * * * /home/admin/xgboost/myenv/bin/python /home/admin/xgboost/infer_xgboost.py >> /home/admin/log/infer_xgboost_cron.log 2>&1
---
この設定では1分ごとに推論ツール(infer_xgboost.py)が起動します。
また、起動した際のログを /home/admin/log配下に「infer_xgboost_cron.log」として残します。
推論ツールでは異常が発生した際に異常レポートを配置しますが、ツール内にprint文も仕掛けている為、正常判定/異常判定に限らず、以下のような標準出力がされます。
{
  "timestamp": "2026-07-02T00:55:00+00:00",
  "actual_bps": 901596.0,
  "predicted_bps": 703784.3125,
  "error_bps": 197811.6875,
  "anomaly_threshold_bps": 399626.73557078006,
  "missing_lag_values": 0,
  "is_anomaly": false
}
crontabにてリダイレクトで標準出力をログに残すよう指定しているので、推論ツールの動作履歴として上の記録を後から確認できます。
これで1分に1回推論処理が実施されるようになりました。
最後に(次の手順に向けて)Python仮想環境から抜けておきます。
(myenv) $ deactivate
これでAIによる判断と制御基盤の準備は完了しました。
準備手順の締めくくりとして、これまで作ってきた各ツールが出力するファイルやツール間の関係を以下の図にまとめます。
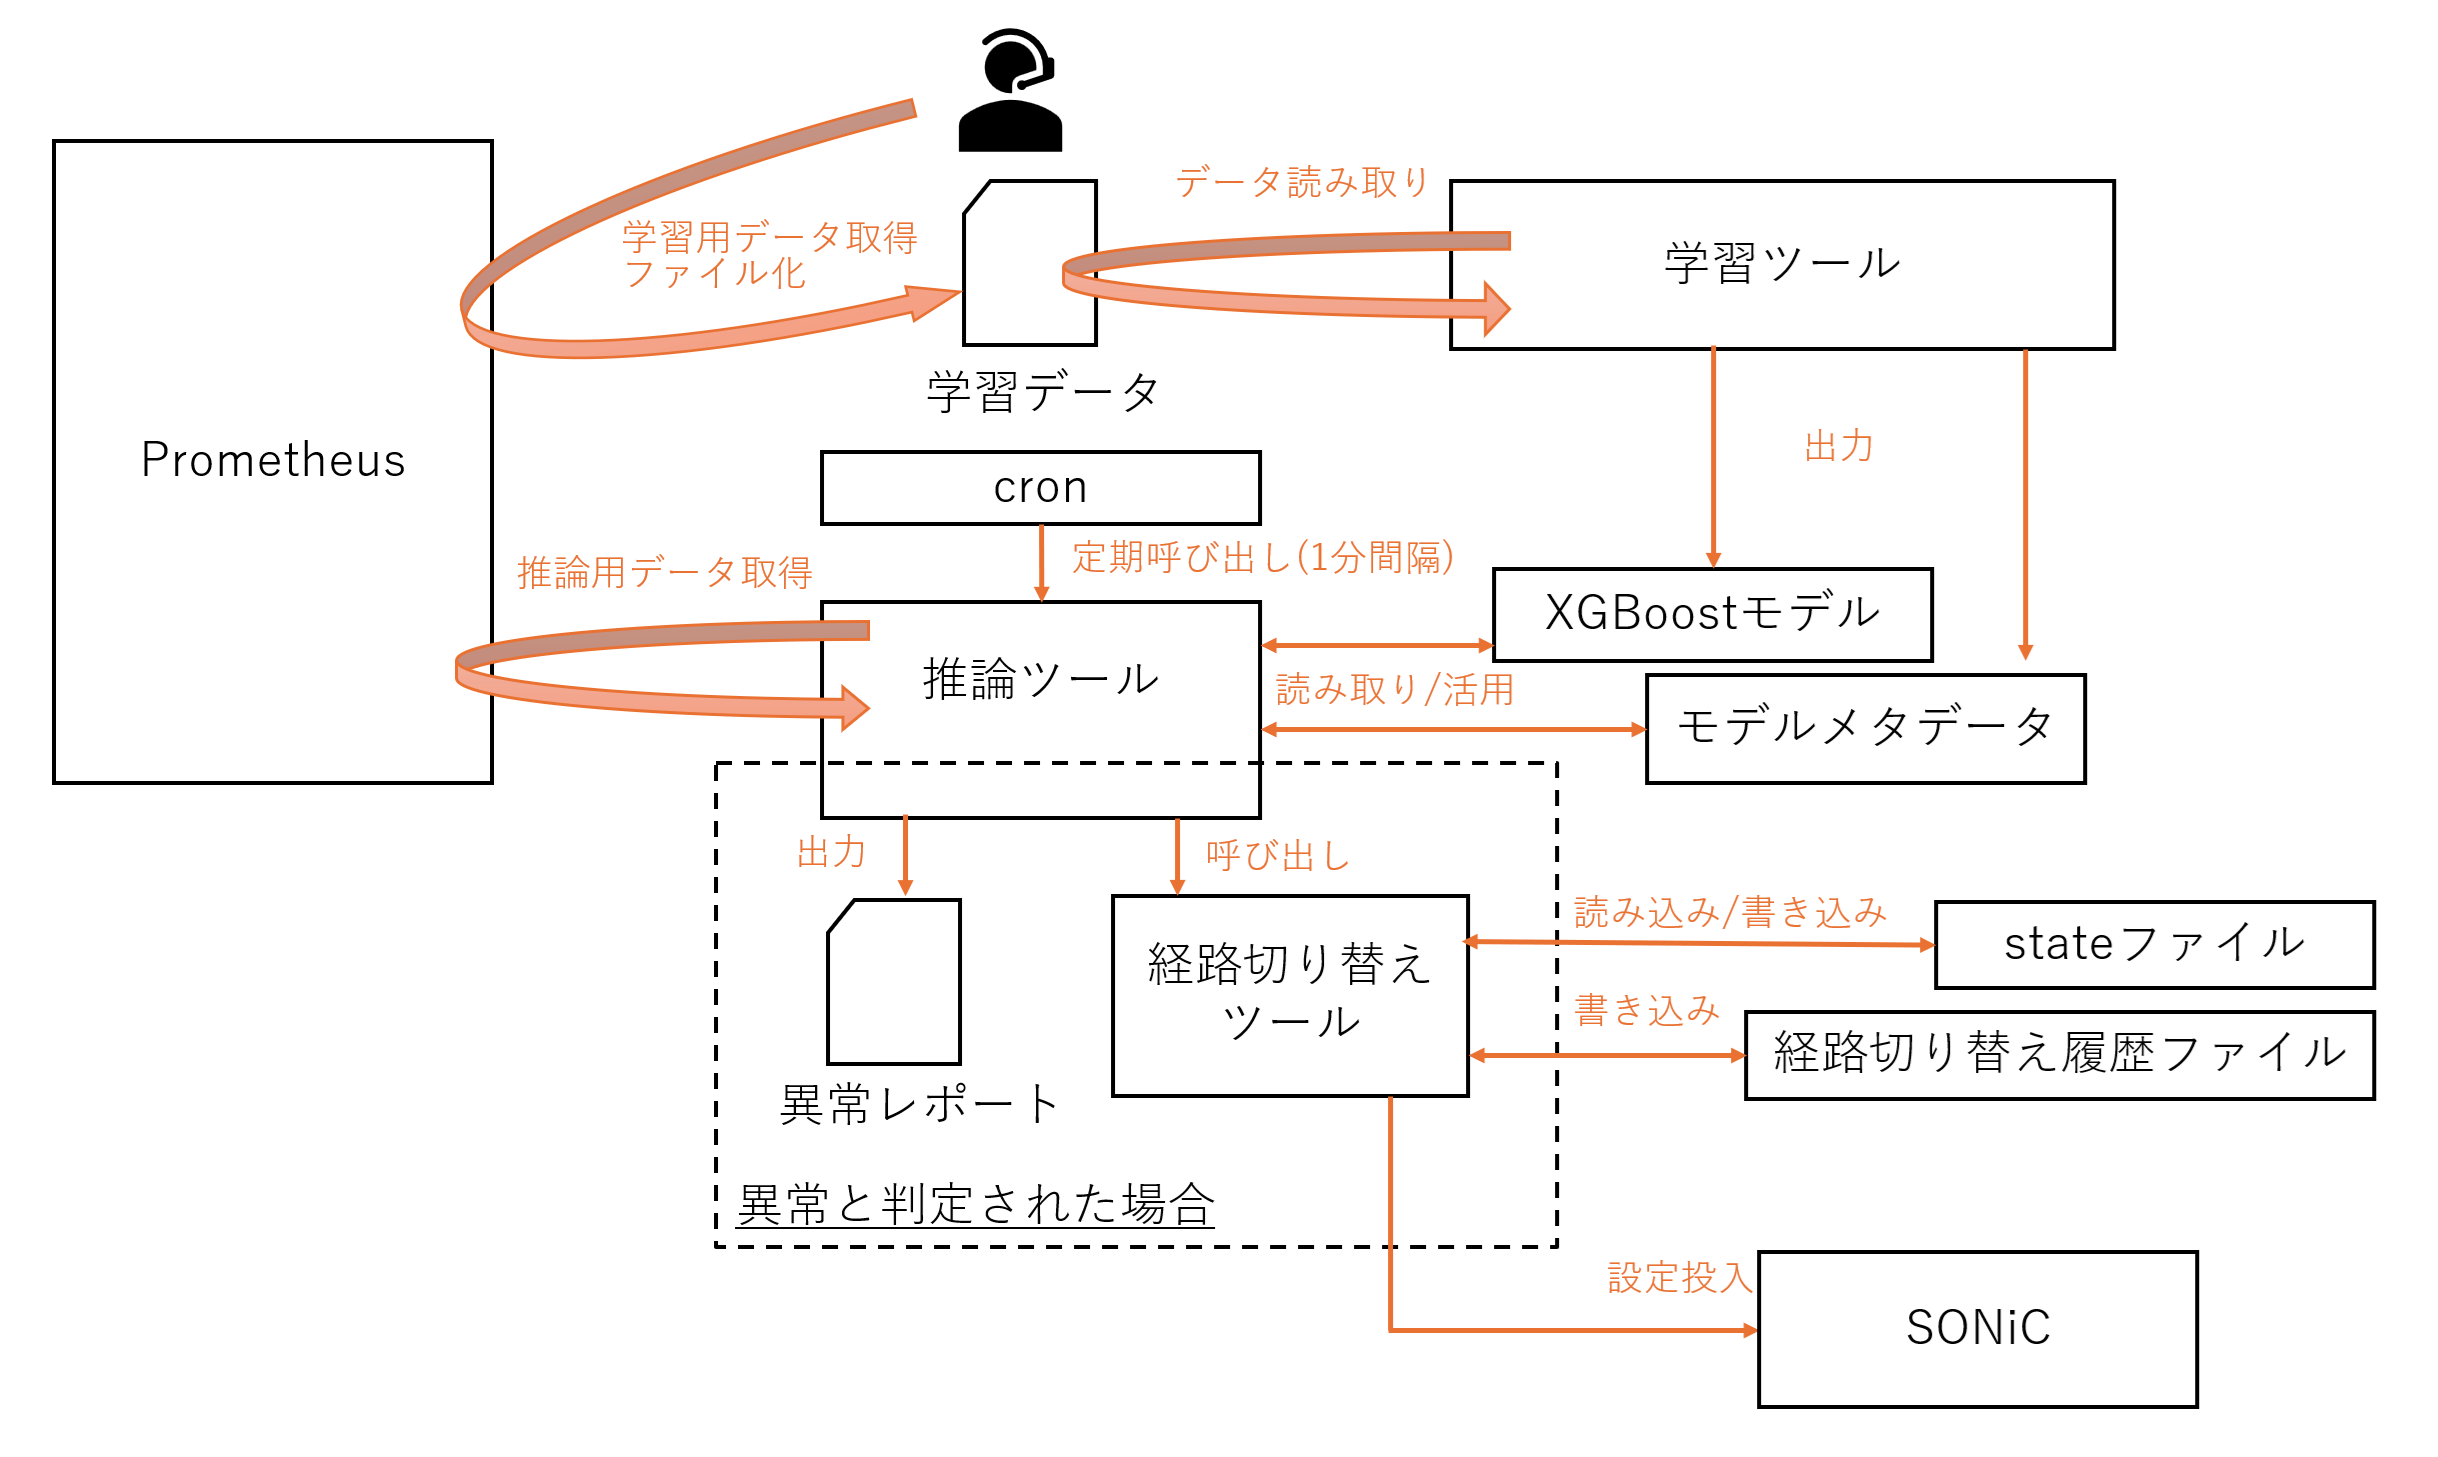
図6-1 各ツールの動作/連動について
本記事での準備/操作説明はこれにて完了です。
| [補足6-1] 判断の扱いについて 本記事で扱う「判断」は「異常かどうかを判定/判断する」という役割である為、どちらかというと「監視」寄りの判断といえます。 なお、判断については必ずしもAIを使う必要性はありません。 |
|---|
| [補足6-2] 実行間隔について 第1回の内容も含めて、様々なデータ取得頻度や動作頻度が登場したかと思いますので、以下にまとめます。
XGBoostによる推論は1分ごとに実行なのに、必要なデータ範囲は3分半である点は、以下のように一部重なりながら値をチェックする動作となります。 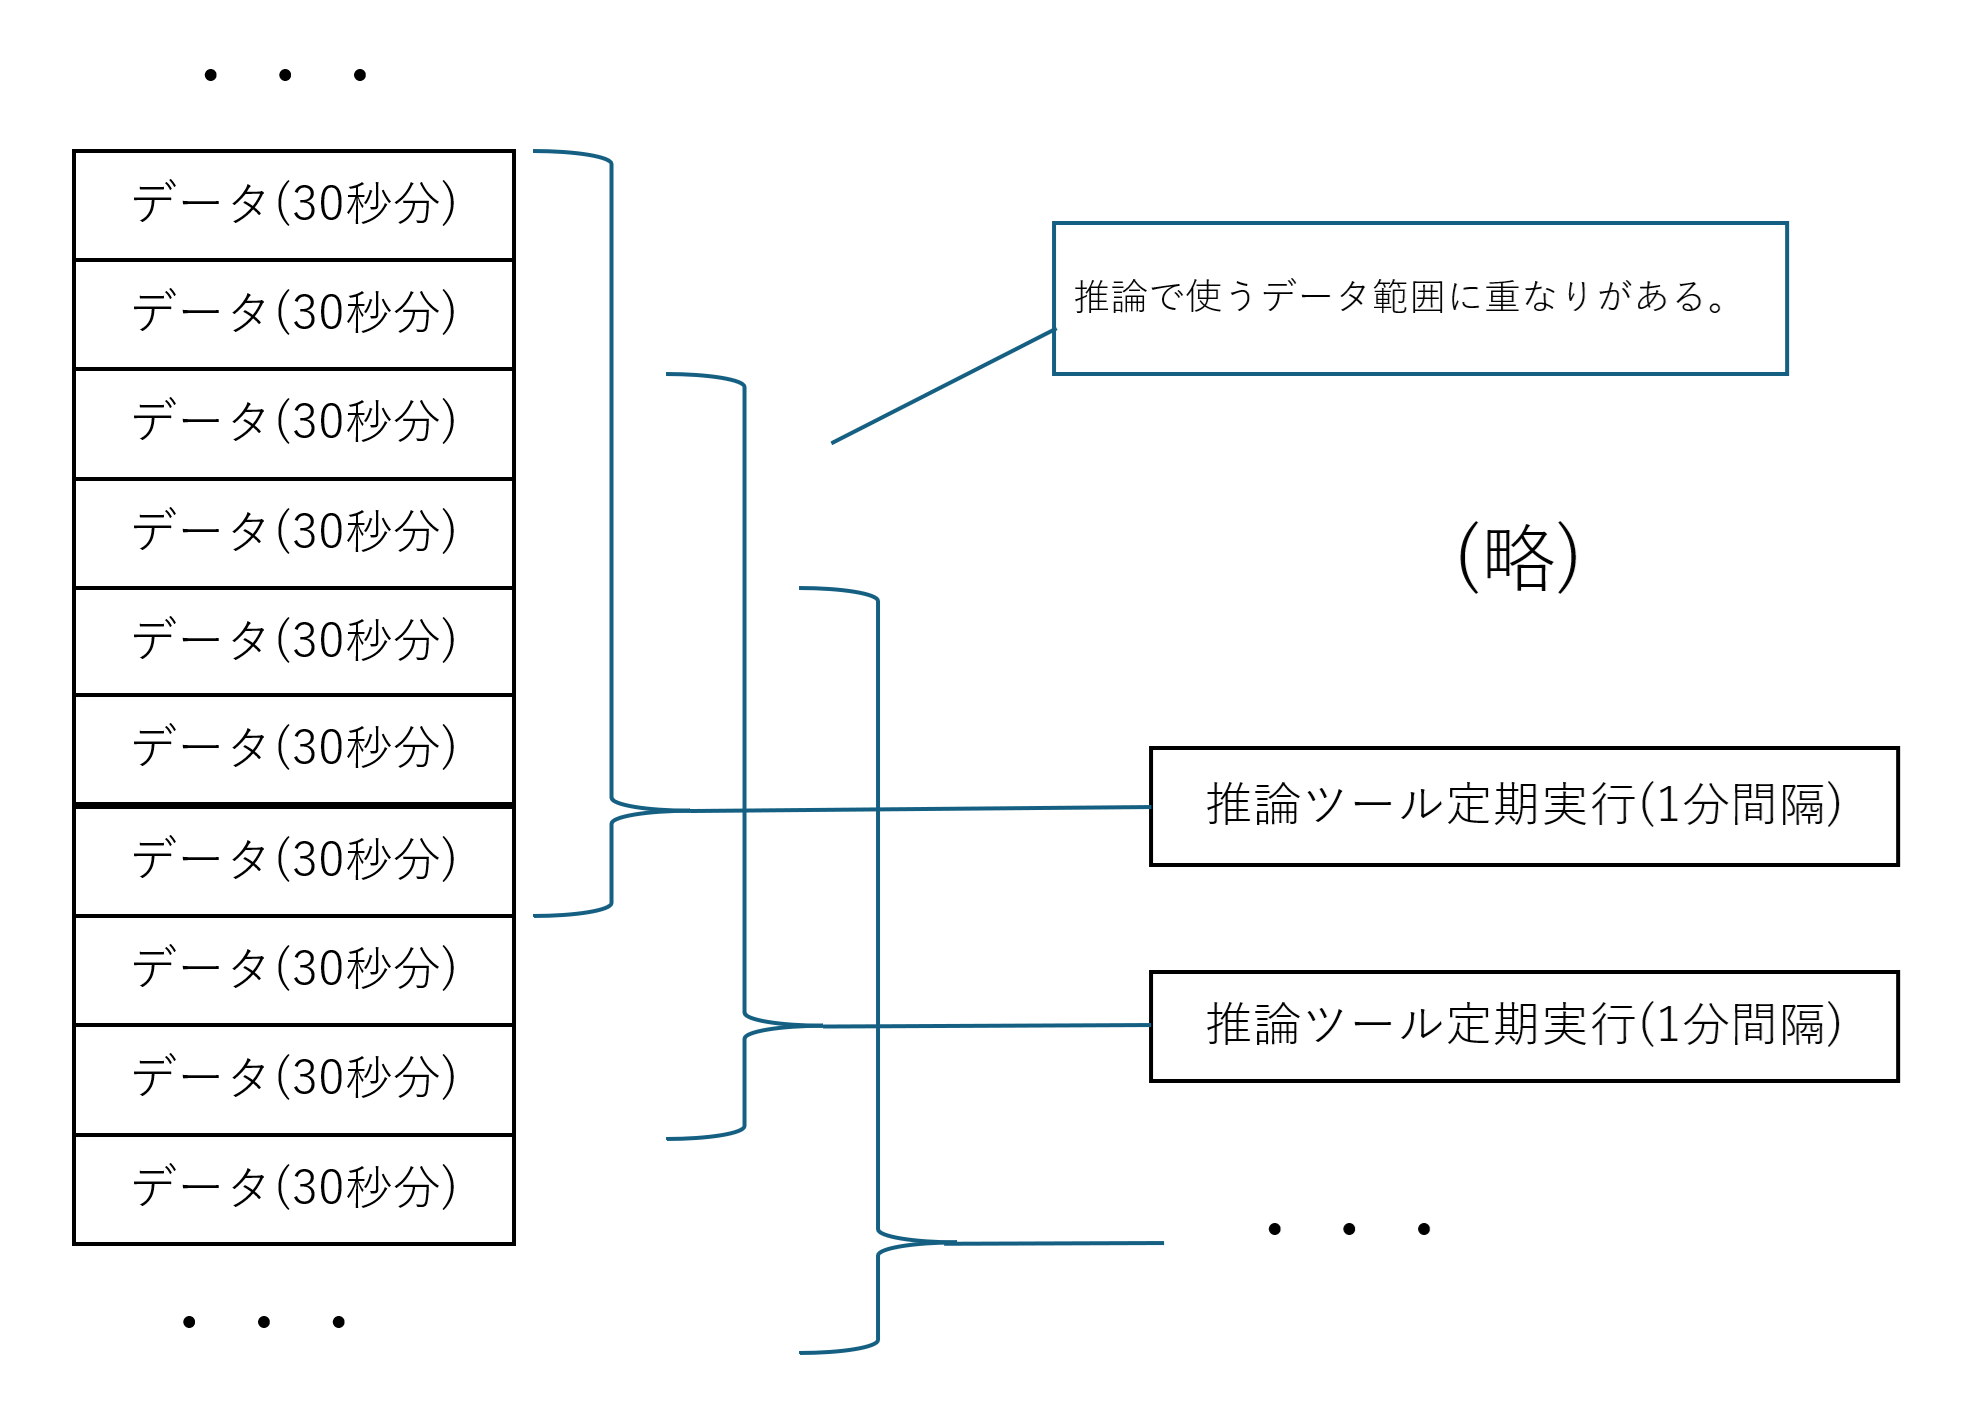
図22 推論の実行間隔と推論に利用するデータの範囲について 今回は例として上の間隔値を設定していますが、実行頻度については柔軟に設定変更が可能です。 |
|---|
おわりに
今回はAI導入に向けた考え方から利用するAIモデル(XGBoost)の紹介、学習/推論コードの紹介、それと連動した経路切り替えツールの用意までを扱いました。
XGBoostを使った推論(傾向外れの検知)も単体試験の内容も踏まえるとイメージがわいたのではないでしょうか。
次回は「LLMによる問い合わせ支援基盤」の構築・周辺技術の紹介と、すべての機能部を使ったシナリオの実施/結果について紹介したいと思います。
本件、またはネットワークに関するご質問がございましたら以下にてお問い合わせください。
最後までご覧いただきありがとうございました。
本件に関するお問い合わせ
<<<<著者プロフィール>>>>
フューチャーネットワーク事業部
第一ビジネスユニット
山口 佳輝(YAMAGUCHI YOSHIKI)
NWに関係したシステム開発を担当しています
>>>>>>>>><<<<<<<<<